

Внешние каталоги в StarRocks
- Обзор
- Ограничения и требования
- Пример использования
- Модель данных в демонстрации
- Последовательность демонстрации
- Необходимые подключения
- Шаг 1. Создание собственной таблицы StarRocks
- Шаг 2. Создание таблицы Hive
- Шаг 3. Создание таблицы Iceberg
- Шаг 4. Добавление таблицы Hive в StarRocks
- Шаг 5. Добавление таблицы Iceberg в StarRocks
- Шаг 6. Объединение данных из трех таблиц
Обзор
Каталоги StarRocks предоставляют механизм доступа к данным, хранящимся в StarRocks и во внешних источниках.
Внутренний каталог управляет данными, хранящимися в StarRocks. В каждом кластере StarRocks есть один внутренний каталог default_catalog. Таблицы, созданные непосредственно в StarRocks, размещаются в этом каталоге.
Внешние каталоги позволяют StarRocks напрямую читать данные из внешних систем без предварительной загрузки или миграции этих данных в StarRocks. StarRocks поддерживает внешние каталоги из таких источников данных, как Apache Hive, Apache Iceberg, Apache Hudi, Delta Lake, JDBC-совместимых источников и других систем. Через один внешний каталог можно предоставлять доступ к различным форматам таблиц озера данных.
Такой подход дает возможность выполнять запросы к различным системам хранения через StarRocks в качестве единой точки доступа и объединять данные из разных внешних источников с собственными данными StarRocks.
Ограничения и требования
Когда StarRocks пишет данные во внешнюю таблицу Hive, файлы сначала записываются во временную директорию по умолчанию /tmp/starrocks, а затем перемещаются в расположение таблицы в /apps/hive/warehouse/*. Чтобы включить запись во внешние таблицы Hive, необходимо определить следующую переменную:
SET GLOBAL ENABLE_WRITE_HIVE_EXTERNAL_TABLE = true;Ограничение Ozone при записи во внешние таблицы Hive
При использовании Ozone запись StarRocks во внешние Hive-таблицы завершается ошибкой, если временная и warehouse-директории Hive находятся в разных бакетах (bucket). Например, ofs://adho/tmp/starrocks и ofs://adho/apps/hive/warehouse принадлежат разным бакетам Ozone, что приводит к ошибке Cannot rename a key to a different bucket.
Укажите временную директорию StarRocks внутри того же Ozone-бакета, например ofs://adho/apps/hive/tmp/starrocks. Это позволит StarRocks перемещать файлы в пределах одного бакета Ozone.
Пример использования
В примере ниже будет продемонстрирован запрос, который объединяет:
-
собственную таблицу StarRocks, хранящуюся в слое shared-data StarRocks;
-
таблицу Hive, метаданные которой хранятся в Hive Metastore;
-
таблицу Iceberg, метаданные которой хранятся в Hive Metastore.
В примере используется кластер ADH на основе трех хостов, в которых развернуты следующие сервисы.
| Хост | Сервис | Компонент |
|---|---|---|
Host 1 |
Core configuration |
Configuration server |
HDFS |
HDFS Client HDFS DataNode HDFS JournalNode HDFS NameNode HDFS ZKFC |
|
Hive |
Hive Client Hive Metastore Hive Tez |
|
Spark3 |
Spark3 Client Spark3 History Server |
|
StarRocks |
StarRocks FE StarRocks CN |
|
YARN |
MapReduce History Server YARN Client YARN NodeManager |
|
Zookeeper |
Zookeeper Server |
|
Host 2 |
HDFS |
HDFS Client HDFS DataNode HDFS HttpFS server HDFS JournalNode |
Hive |
Hive Client Hive HiveServer2 Hive Metastore Hive Tez Hive Tez UI |
|
Spark3 |
Spark3 Client Spark3 Livy Server |
|
StarRocks |
StarRocks FE StarRocks CN |
|
YARN |
YARN Client YARN NodeManager YARN ResourceManager |
|
Zookeeper |
Zookeeper Server |
|
Host 3 |
ADPG |
Arenadata PostgreSQL |
HDFS |
HDFS Client HDFS DataNode HDFS JournalNode HDFS NameNode HDFS ZKFC |
|
Hive |
Hive Client Hive Metastore Hive Tez |
|
Spark3 |
Spark3 Client Spark3 Connect |
|
StarRocks |
StarRocks FE StarRocks CN |
|
YARN |
YARN Client YARN NodeManager YARN Timeline Server |
|
Zookeeper |
Zookeeper Server |
Для установленного кластера ADH из коробки выполнено следующее:
-
Если сервис HDFS установлен, он используется в качестве общего хранилища данных для StarRocks.
-
Hive Metastore настроен и доступен для StarRocks. Компоненты StarRocks Frontend (FE) и Compute Nodes (CN) могут обращаться к путям HDFS, возвращаемым Hive Metastore.
-
Каталог Spark по умолчанию (
spark_catalog) поддерживает Iceberg-таблицы.
В этом демонстрационном примере для подключения к системам хранения данных используется DBeaver.
Модель данных в демонстрации
В примере используются три таблицы, представляющие собой простой набор данных о продажах.
| Таблица | Тип | Назначение |
|---|---|---|
orders |
StarRocks |
Содержит заказы и ссылки на клиента и товар |
customers |
Hive |
Содержит информацию о клиентах |
products |
Iceberg |
Содержит информацию о товарах |
Таблицы связаны следующим образом:
-
orders.customer_id→customers.customer_id -
orders.product_id→products.product_id
Итоговый запрос объединяет три таблицы и возвращает информацию о заказах, клиентах и товарах.
Последовательность демонстрации
Демонстрация состоит из следующих шагов:
-
Создание собственной таблицы StarRocks
ordersс помощью DBeaver. -
Создание таблицы Hive
customersс помощью DBeaver. -
Создание таблицы Iceberg
productsс помощью Spark3 и предварительно настроенногоspark_catalog. -
Добавление Hive-таблицы в StarRocks в качестве внешнего каталога.
-
Добавление Iceberg-таблицы в StarRocks в качестве внешнего каталога.
-
Выполнение с помощью DBeaver запроса из StarRocks, объединяющего все три таблицы.
Необходимые подключения
Перед началом демонстрации убедитесь, что у вас есть необходимые подключения.
-
StarRocks FE. Для подключения можно использовать JDBC-строку из ADCM на вкладке Services → StarRocks → Info.
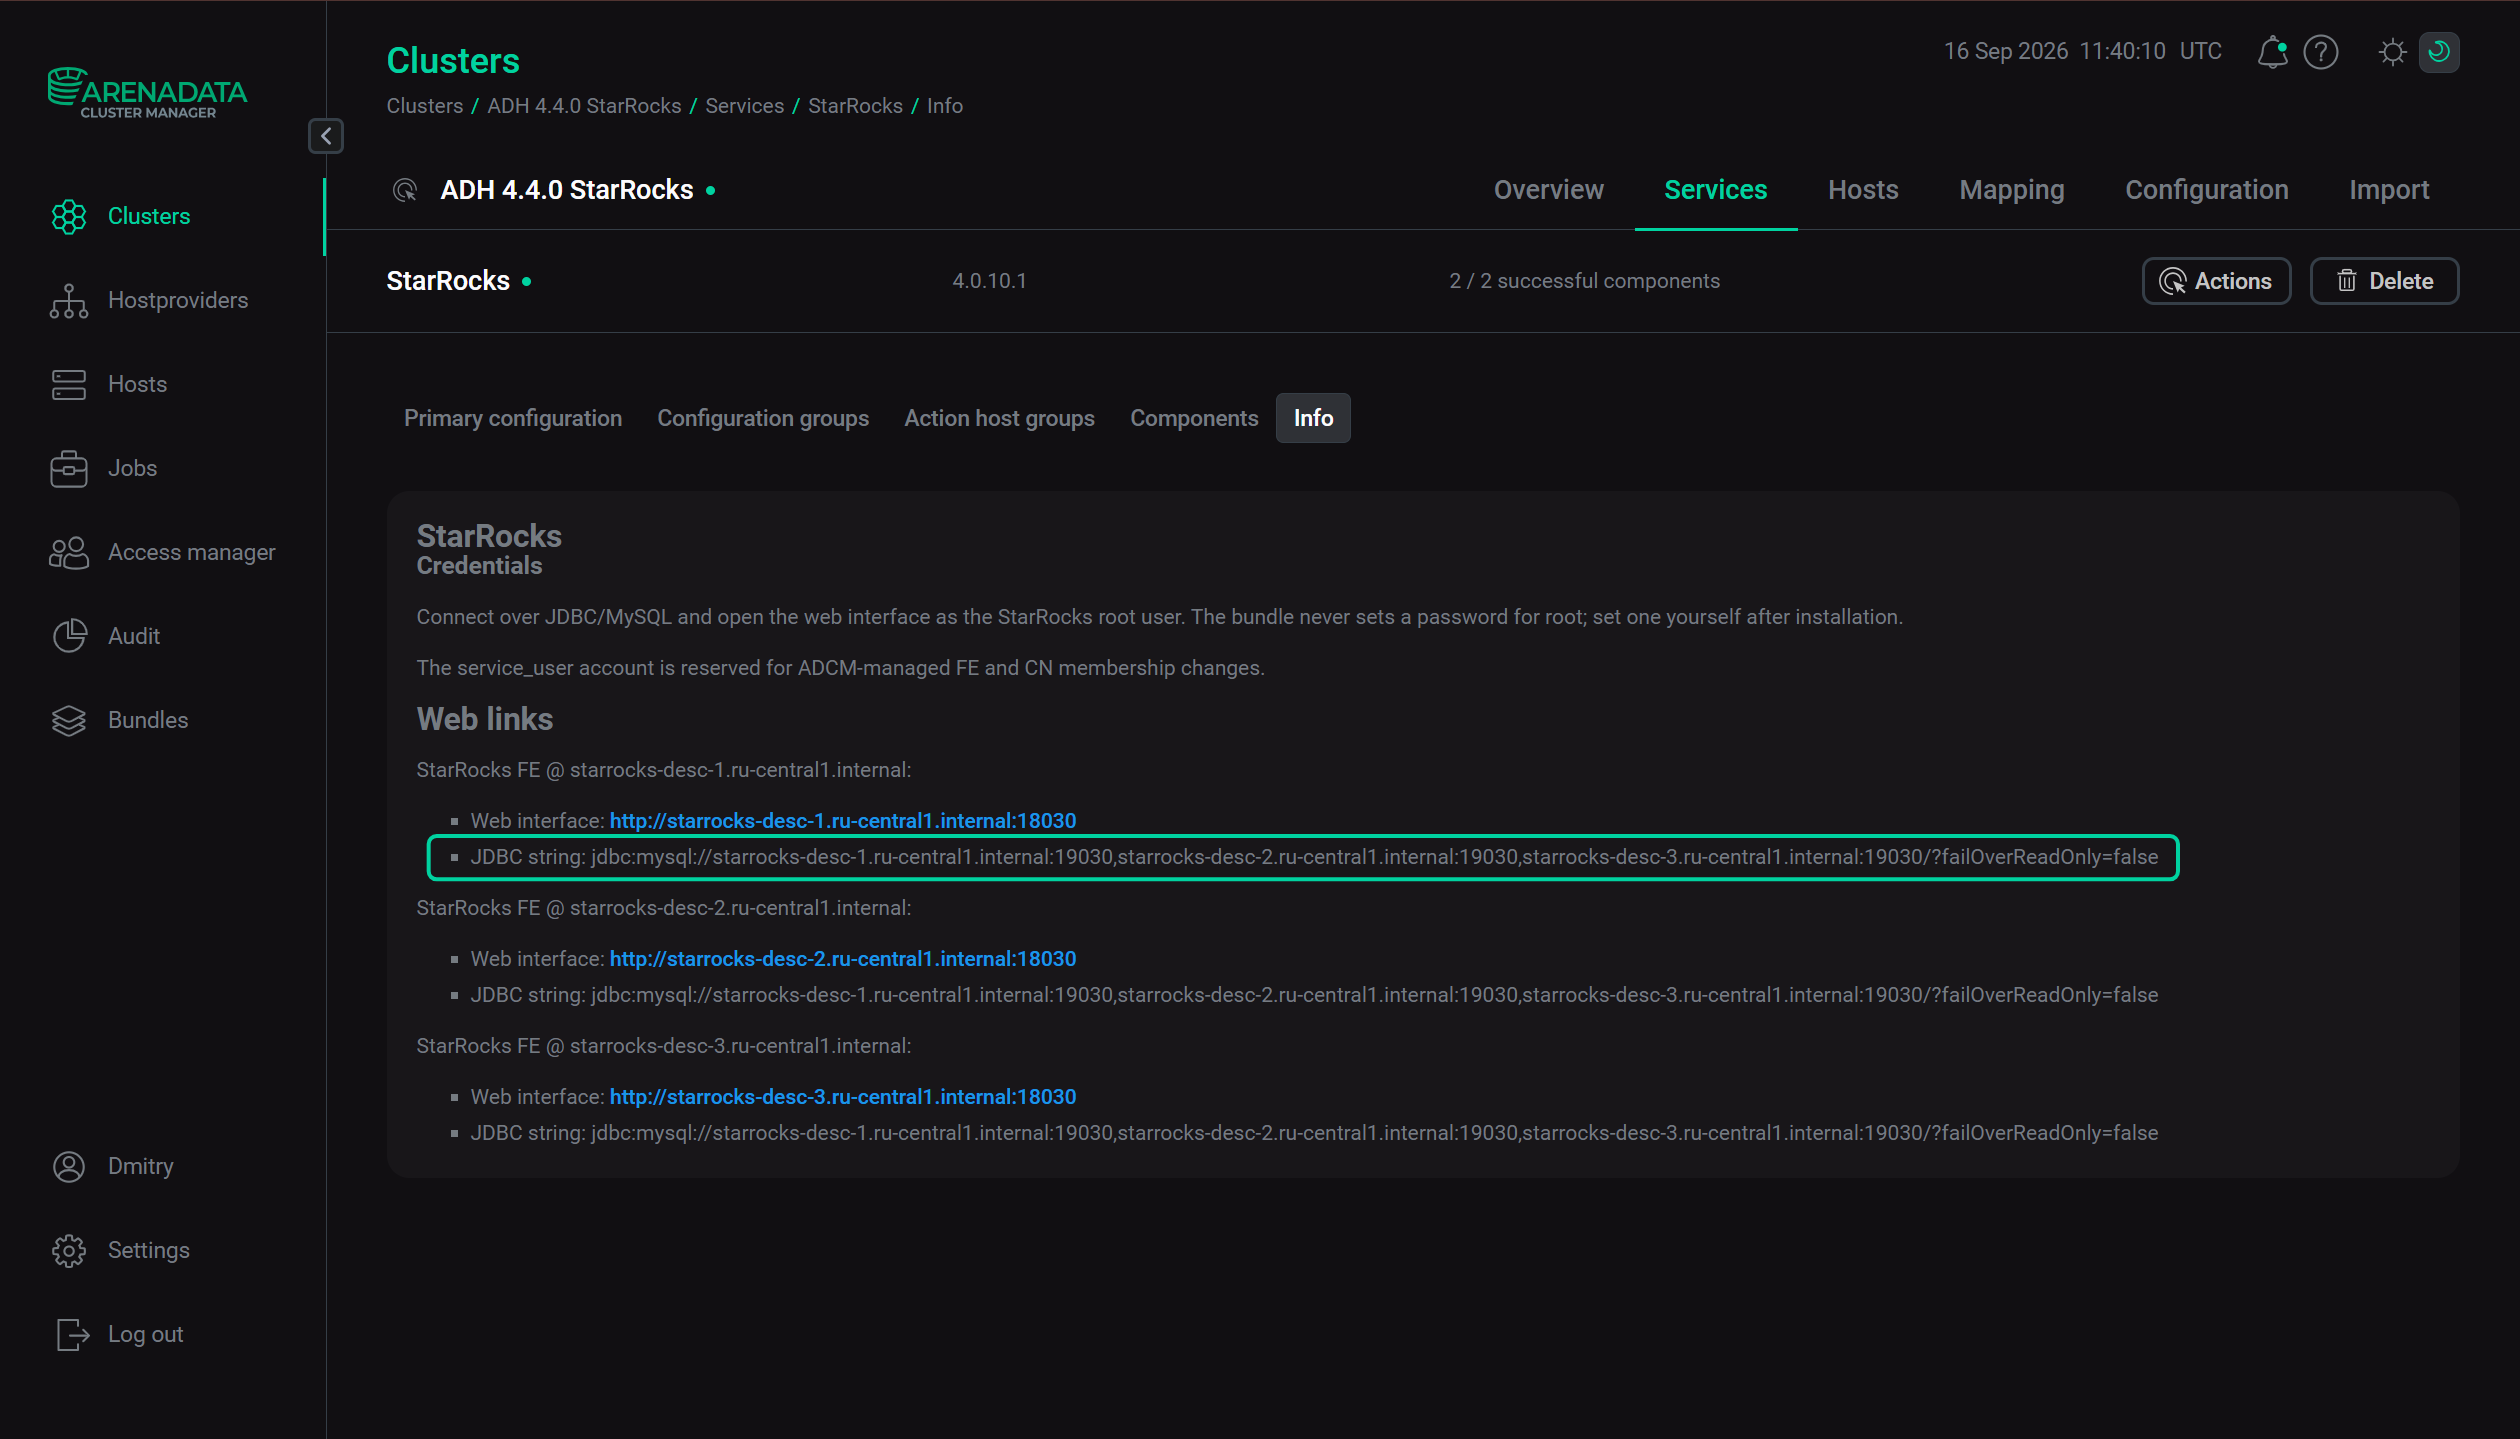 Вкладка Info сервиса StarRocks
Используйте ее для подключения к StarRocks в DBeaver.
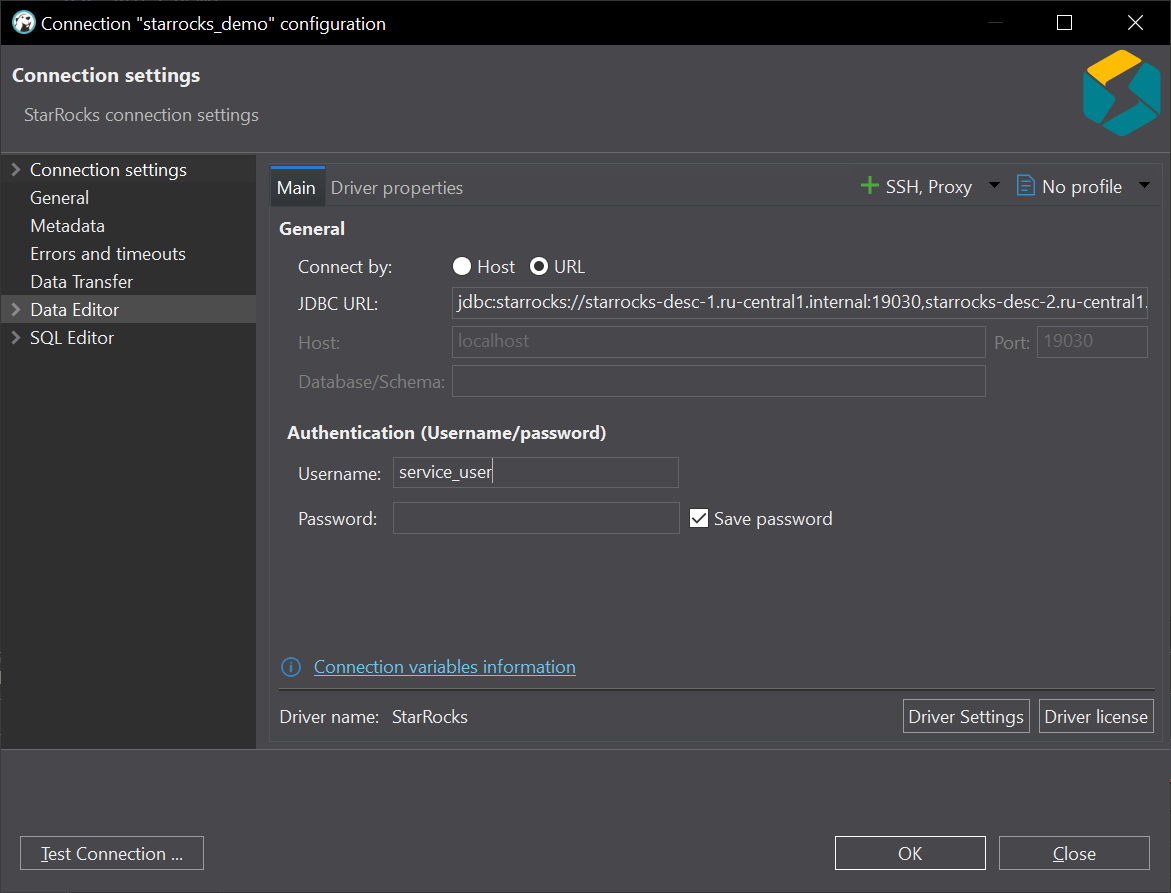 Подключение к StarRocks в DBeaver
-
Подключение к HiveServer2. Для подключения можно использовать JDBC-строку из ADCM на вкладке Services → Hive → Info.
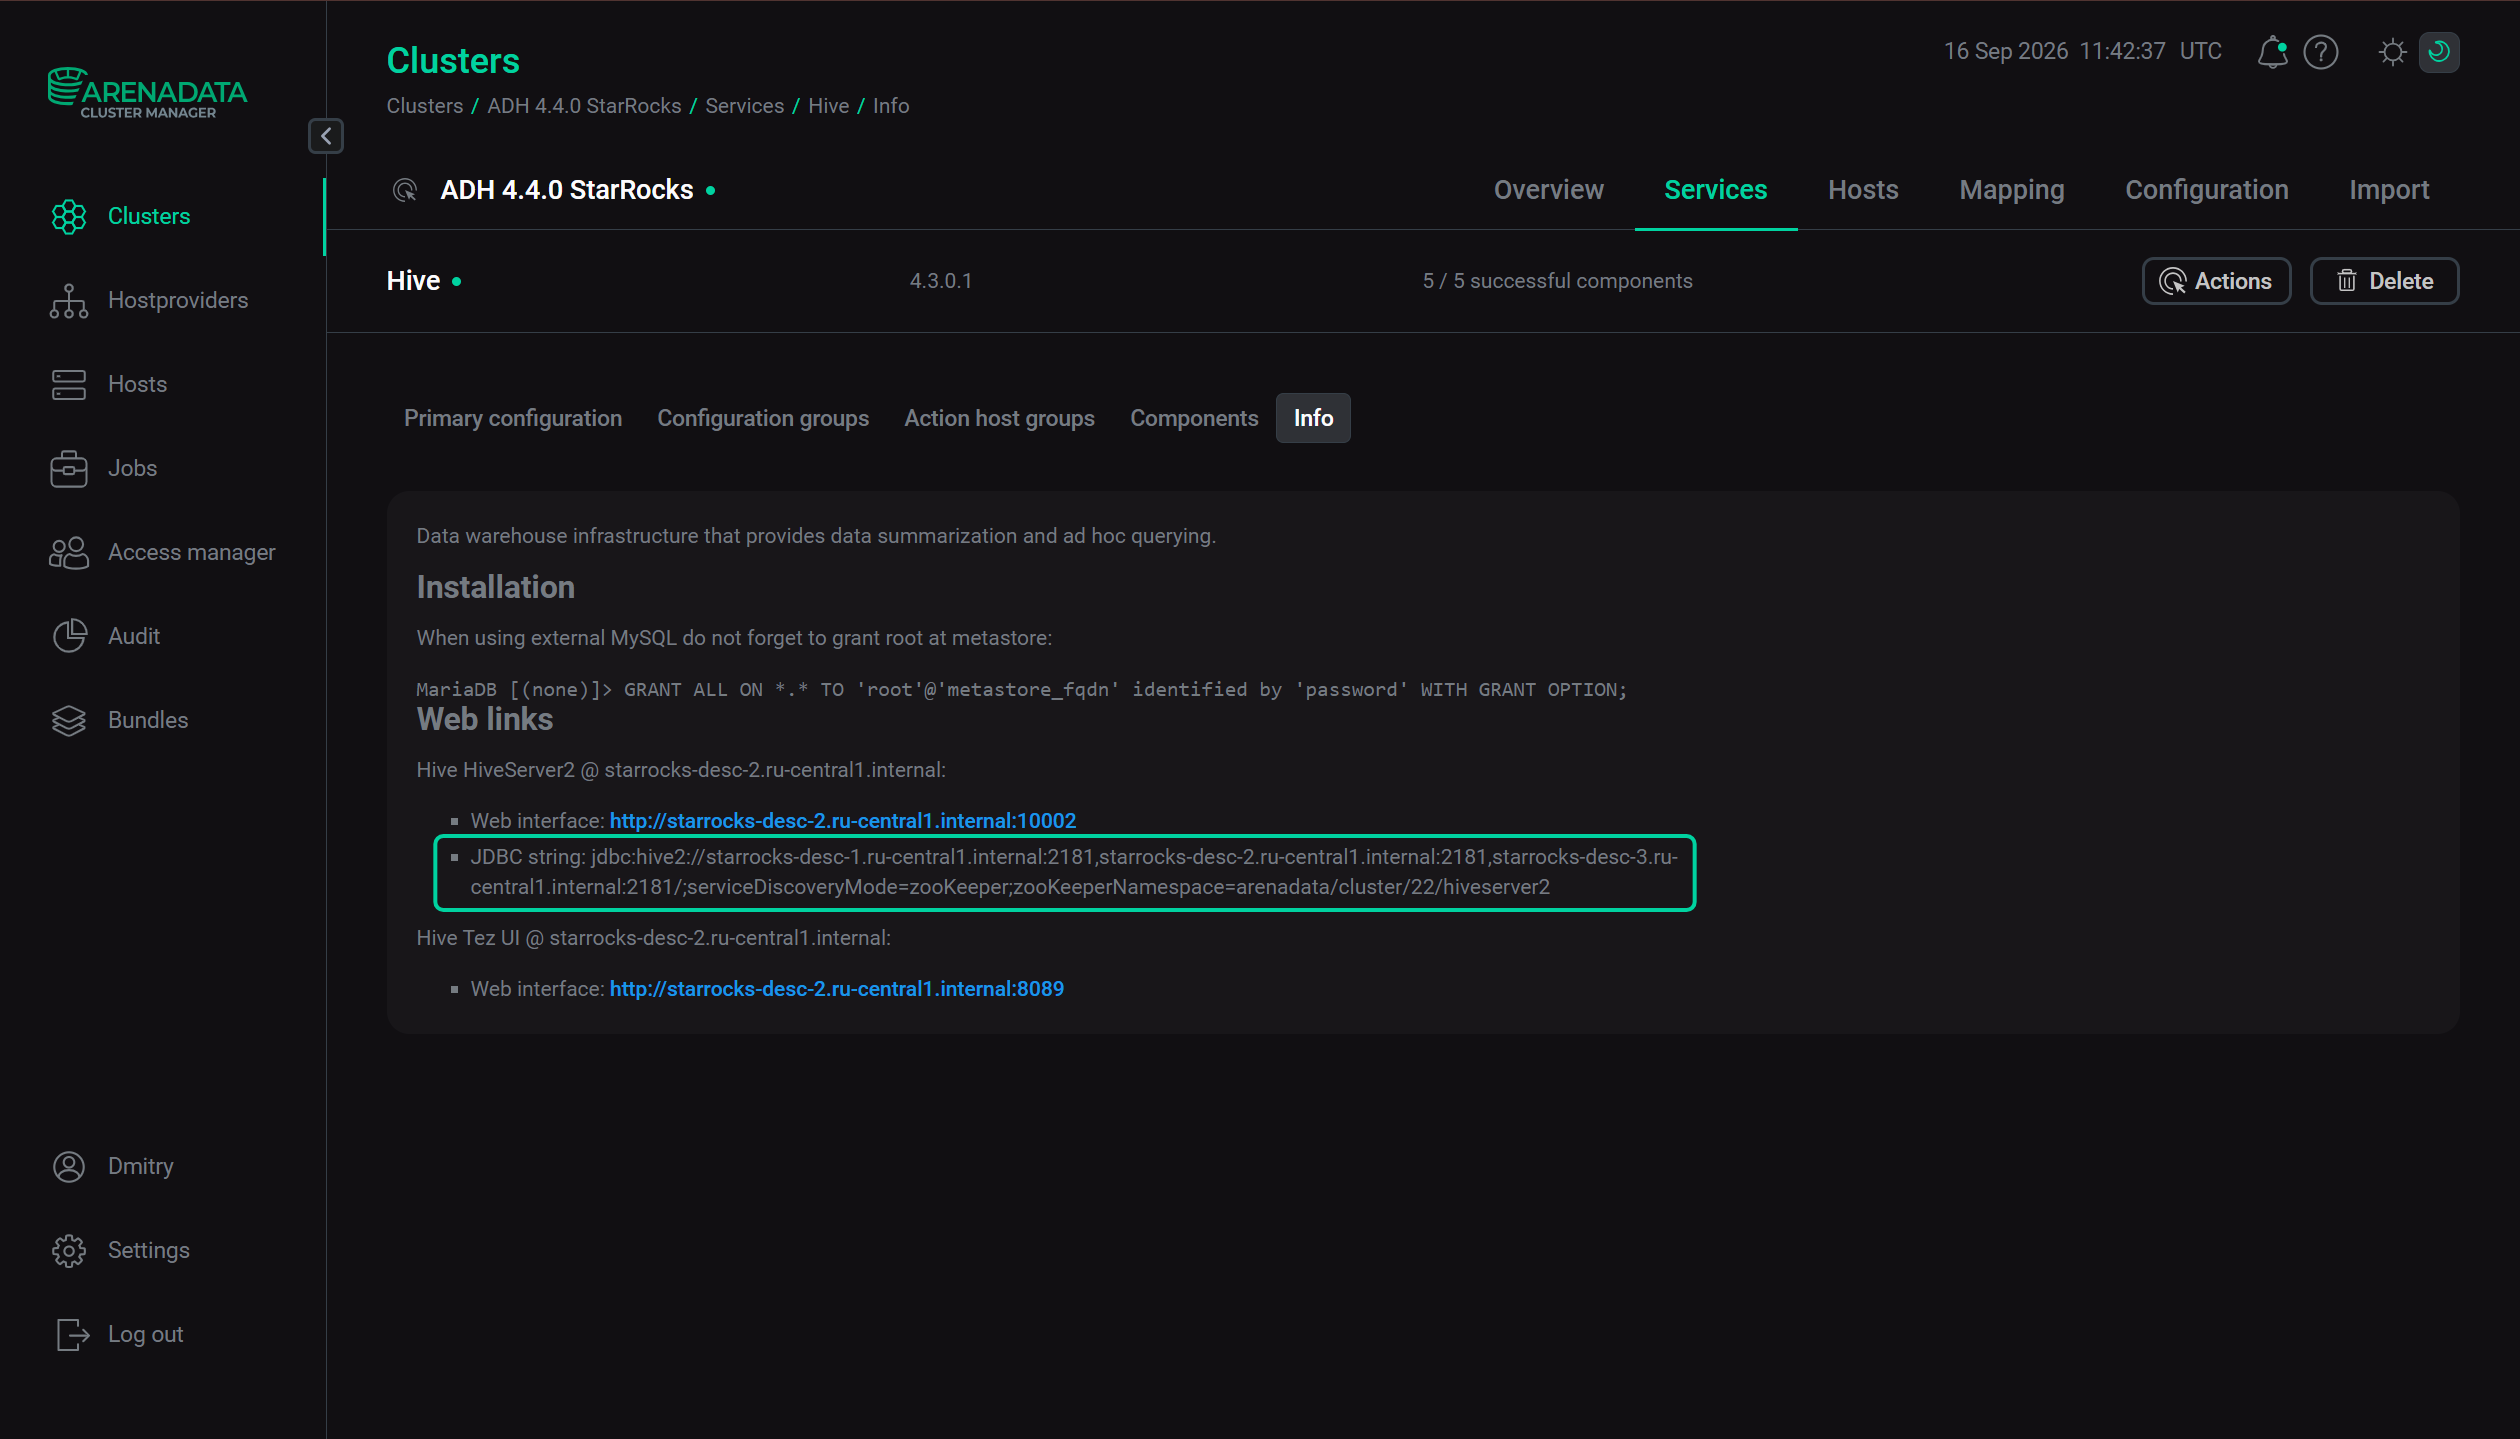 Вкладка Info сервиса Hive
Используйте ее для подключения к Hive в DBeaver.
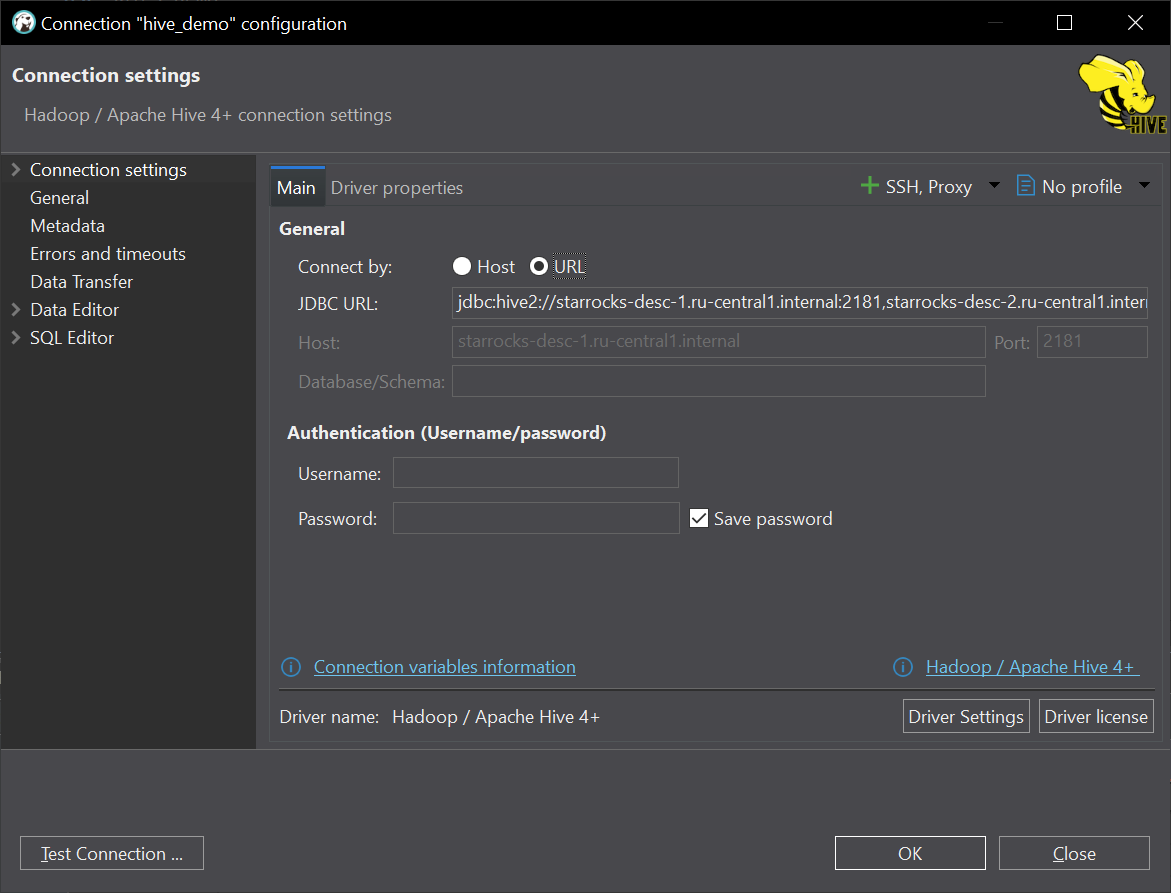 Подключение к Hive в DBeaver
-
Подключение к Hive Metastore через Spark-клиент. Spark используется только для создания и заполнения таблицы Iceberg.
Шаг 1. Создание собственной таблицы StarRocks
Используйте DBeaver для подключения к StarRocks.
-
Создайте базу данных:
CREATE DATABASE IF NOT EXISTS starrocks_sales; -
Переключитесь на эту базу данных:
USE starrocks_sales; -
Создайте таблицу
orders:CREATE TABLE orders ( order_id BIGINT, customer_id BIGINT, product_id BIGINT, order_date DATE, quantity INT ) PRIMARY KEY (order_id) DISTRIBUTED BY HASH (order_id) PROPERTIES ( "replication_num" = "3" ); -
Заполните ее данными:
INSERT INTO orders ( order_id, customer_id, product_id, order_date, quantity ) VALUES (1001, 1, 101, '2026-09-01', 2), (1002, 2, 102, '2026-09-02', 1), (1003, 1, 103, '2026-09-03', 5), (1004, 3, 101, '2026-09-04', 3); -
Проверьте таблицу:
SELECT *
FROM starrocks_sales.orders
ORDER BY order_id;
Эта таблица будет храниться и управляться StarRocks и будет располагаться во внутреннем каталоге
default_catalog.Проверить определение таблицы можно с помощью следующей команды:
SHOW CREATE TABLE starrocks_sales.orders;
Шаг 2. Создание таблицы Hive
Таблица Hive создается не из StarRocks.
Используйте DBeaver для подключения к HiveServer2. Не используйте подключение к StarRocks или Spark для создания этой Hive-таблицы.
-
Создайте базу данных Hive:
CREATE DATABASE IF NOT EXISTS hive_sales; -
Переключитесь на нее:
USE hive_sales; -
Создайте таблицу
customers:CREATE TABLE customers ( customer_id BIGINT, customer_name STRING, city STRING ) STORED AS PARQUET; -
Заполните ее данными:
INSERT INTO customers (customer_id, customer_name, city) VALUES (1, 'Alice Brown', 'Moscow'), (2, 'Bob Smith', 'Saint Petersburg'), (3, 'Carol White', 'Kazan'); -
Проверьте таблицу через подключение Hive в DBeaver:
SELECT *
FROM customers
ORDER BY customer_id;
Шаг 3. Создание таблицы Iceberg
Таблица Iceberg создается с помощью Spark3.
-
Запустите сеанс Spark3 SQL на одном из хостов кластера со Spark-клиентом:
$ spark3-sql -
Создайте пространство имен
iceberg_sales:CREATE NAMESPACE IF NOT EXISTS iceberg_sales; -
Проверьте пространство имен:
SHOW NAMESPACES; -
Создайте Iceberg-таблицу
products:CREATE TABLE iceberg_sales.products ( product_id BIGINT, product_name STRING, category STRING, price DECIMAL(10, 2) ) USING iceberg; -
Вставьте пример данных:
INSERT INTO iceberg_sales.products (product_id, product_name, category, price) VALUES (101, 'Laptop', 'Electronics', 1200.00), (102, 'Keyboard', 'Electronics', 80.00), (103, 'Office Chair', 'Furniture', 250.00); -
Проверьте таблицу:
SELECT *
FROM iceberg_sales.products
ORDER BY product_id;
Также можно просмотреть метаданные таблицы из Spark:
DESCRIBE TABLE iceberg_sales.products;
На этом этапе созданы три независимые таблицы:
-
starrocks_sales.orders; -
hive_sales.customers; -
iceberg_sales.products.
Шаг 4. Добавление таблицы Hive в StarRocks
Следующий шаг — сделать таблицу Hive доступной в StarRocks через внешний каталог.
-
Подключитесь к StarRocks в DBeaver и выполните следующую команду:
CREATE EXTERNAL CATALOG hive_catalog PROPERTIES (
        "type" = "hive", (1)
        "hive.metastore.type" = "hive", (2)
        "hive.metastore.uris" = "thrift://<hive-metastore-host>:<hive-metastore-thrift-port>" (3)
);
1 Свойство typeопределяет внешний источник данных как Hive.2 Свойство hive.metastore.typeуказывает, что служба метаданных является Hive Metastore.3 Свойство hive.metastore.urisуказывает эндпоинт Hive Metastore. StarRocks использует этот эндпоинт для получения метаданных о базах данных, таблицах, схемах и расположении данных.В этом демонстрационном кластере доступны три эндпоинта Hive Metastore. Все три указываются в
hive.metastore.uris:CREATE EXTERNAL CATALOG hive_catalog COMMENT "Hive external catalog" PROPERTIES ( "type" = "hive", "hive.metastore.type" = "hive", "hive.metastore.uris" = "thrift://starrocks-desc-1.ru-central1.internal:9083,thrift://starrocks-desc-2.ru-central1.internal:9083,thrift://starrocks-desc-3.ru-central1.internal:9083" );
Проверка каталога Hive
-
Выведите список каталогов:
SHOW CATALOGS;В результате должны присутствовать внутренний каталог и созданный каталог Hive. Команда
SHOW CATALOGSотображаетdefault_catalogкакInternal, а внешние каталоги — в соответствии с настроенным для них типом. -
Проверьте конфигурацию каталога:
SHOW CREATE CATALOG hive_catalog;SHOW CREATE CATALOGотображает команду, использованную для создания каталога.
Проверка базы данных и таблицы Hive
-
Выведите список баз данных, доступных через каталог Hive:
SHOW DATABASES FROM hive_catalog;В списке должна присутствовать база данных
hive_sales. -
Выведите список ее таблиц:
SHOW TABLES FROM hive_catalog.hive_sales;В результате должна присутствовать таблица
customers. -
Просмотреть ее схему можно с помощью команды:
DESCRIBE hive_catalog.hive_sales.customers; -
Также можно напрямую выполнить запрос к таблице:
SELECT *
FROM hive_catalog.hive_sales.customers
ORDER BY customer_id;
Шаг 5. Добавление таблицы Iceberg в StarRocks
Доступ к таблице Iceberg осуществляется через отдельный каталог Iceberg в StarRocks.
Поскольку в этом примере таблица Iceberg использует Hive Metastore для хранения метаданных каталога, настройте каталог StarRocks для использования реализации каталога Hive.
-
Выполните следующую команду из подключения StarRocks в DBeaver:
CREATE EXTERNAL CATALOG iceberg_catalog PROPERTIES (
        "type" = "iceberg", (1)
        "iceberg.catalog.type" = "hive", (2)
        "iceberg.catalog.hive.metastore.uris" = "thrift://<hive-metastore-host>:<hive-metastore-thrift-port>" (3)
);
1 Свойство typeуказывает Iceberg как внешний источник данных.2 Свойство iceberg.catalog.typeопределяет реализацию каталога Iceberg. В этом примере используетсяhive.3 Свойство iceberg.catalog.hive.metastore.urisуказывает эндпоинт Hive Metastore, используемый для получения метаданных Iceberg. StarRocks поддерживает каталоги Iceberg, использующие Hive Metastore.В этом демонстрационном кластере доступны три эндпоинта Hive Metastore. Все три указываются в
iceberg.catalog.hive.metastore.uris:CREATE EXTERNAL CATALOG iceberg_catalog COMMENT "Iceberg external catalog" PROPERTIES ( "type" = "iceberg", "iceberg.catalog.type" = "hive", "iceberg.catalog.hive.metastore.uris" = "thrift://starrocks-desc-1.ru-central1.internal:9083,thrift://starrocks-desc-2.ru-central1.internal:9083,thrift://starrocks-desc-3.ru-central1.internal:9083" );
|
ПРИМЕЧАНИЕ
Тот факт, что Spark использует каталог |
Проверка каталога и пространства имен Iceberg
-
Проверьте определение каталога Iceberg:
SHOW CREATE CATALOG iceberg_catalog; -
Выведите список баз данных, доступных в каталоге Iceberg:
SHOW DATABASES FROM iceberg_catalog;В результате должна присутствовать база данных
iceberg_sales. -
Проверьте таблицу:
DESCRIBE iceberg_catalog.iceberg_sales.products; -
Выполните запрос к созданной таблице:
SELECT * FROM iceberg_catalog.iceberg_sales.products ORDER BY product_id; -
Теперь можно вывести список всех каталогов в StarRocks:
SHOW CATALOGS;В результате должны присутствовать следующие внешние каталоги:
default_catalog
hive_catalog
iceberg_catalog
Список каталогов также отображается в разделе System → catalogs веб-интерфейса StarRocks.
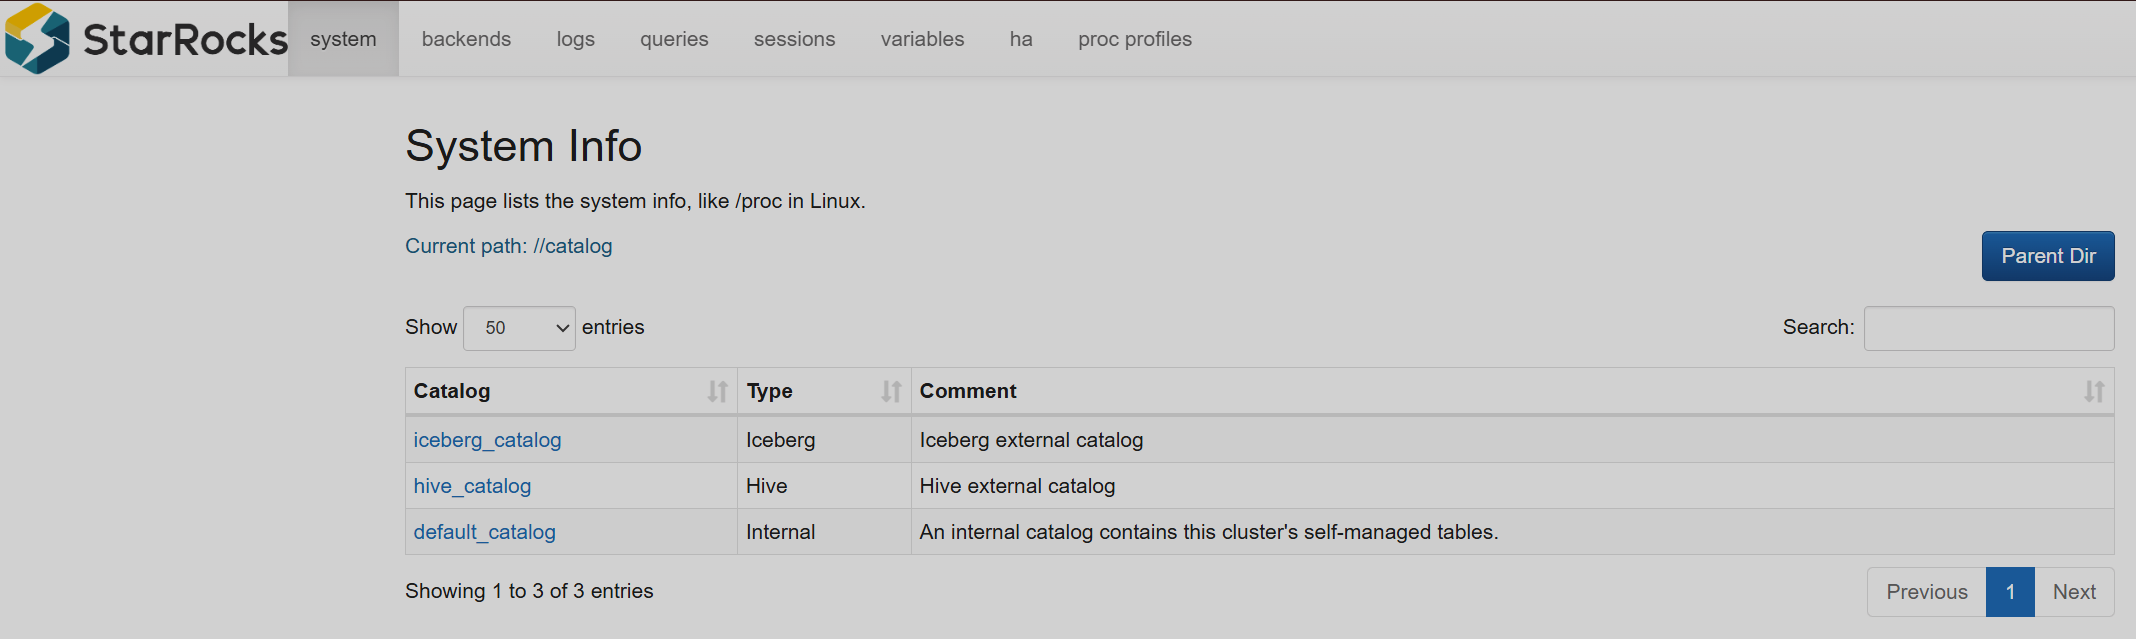 Список каталогов в веб-интерфейсе
 Список каталогов в веб-интерфейсе
Шаг 6. Объединение данных из трех таблиц
Три таблицы можно объединить в одном запросе. В этом примере собственная таблица StarRocks orders содержит данные о заказах, а таблицы Hive customers и Iceberg products содержат атрибуты клиентов и товаров.
| Каталог | Тип каталога | Таблица |
|---|---|---|
default_catalog |
Внутренний StarRocks |
starrocks_sales.orders |
hive_catalog |
Внешний Hive |
hive_sales.customers |
iceberg_catalog |
Внешний Iceberg |
iceberg_sales.products |
Выполните следующий запрос из подключения StarRocks в DBeaver:
SELECT
        c.customer_id,
        c.customer_name,
        c.city,
        p.category,
        COUNT(DISTINCT o.order_id) AS order_count,
        SUM(o.quantity) AS total_quantity,
        SUM(o.quantity * p.price) AS total_amount,
        AVG(o.quantity * p.price) AS average_order_amount
FROM
        default_catalog.starrocks_sales.orders AS o
        JOIN hive_catalog.hive_sales.customers AS c ON o.customer_id = c.customer_id
        JOIN iceberg_catalog.iceberg_sales.products AS p ON o.product_id = p.product_id
GROUP BY
        c.customer_id,
        c.customer_name,
        c.city,
        p.category
ORDER BY
        total_amount DESC;
Для приведенных в примере данных результат будет выглядеть примерно следующим образом.
┌─Customer──────┬─City──────────────┬─Category────┬─Orders─┬─Quantity─┬─Total amount─┬─Average order──┐
│ Alice Brown   │ Moscow            │ Electronics │      1 │        2 │      2400.00 │        2400.00 │
│ Alice Brown   │ Moscow            │ Furniture   │      1 │        5 │      1250.00 │        1250.00 │
│ Bob Smith     │ Saint Petersburg  │ Electronics │      1 │        1 │        80.00 │          80.00 │
│ Carol White   │ Kazan             │ Electronics │      1 │        3 │      3600.00 │        3600.00 │
└───────────────┴───────────────────┴─────────────┴────────┴──────────┴──────────────┴────────────────┘
|
ВАЖНО
В этом примере все три каталога используют один и тот же HDFS-кластер для хранения данных. Однако у внешних каталогов нет ограничения на размещение в одном кластере: можно подключать системы, развернутые в других кластерах, если у StarRocks есть к ним доступ. |