

Перезапись непартиционированных таблиц Hive
В данной статье описаны особенности записи данных в непартиционированные (unpartitioned) таблицы Hive с помощью сервиса Spark3.
Стандартная процедура перезаписи
По умолчанию при использовании Spark для записи данных в непартиционированную таблицу Hive в режиме перезаписи (overwrite mode) иногда возможны потери данных при определенных условиях и настройках. Пример кода Spark для записи содержимого DataFrame в таблицу в режиме перезаписи приведен ниже.
df.write \
  .mode("overwrite") \
  .format("orc") \
  .insertInto(table_name)
Следующие параметры Spark могут использоваться для обеспечения pushdown-операций и оптимизации работы:
spark.sql.hive.convertMetastoreOrc = true
spark.sql.hive.convertMetastoreParquet = true
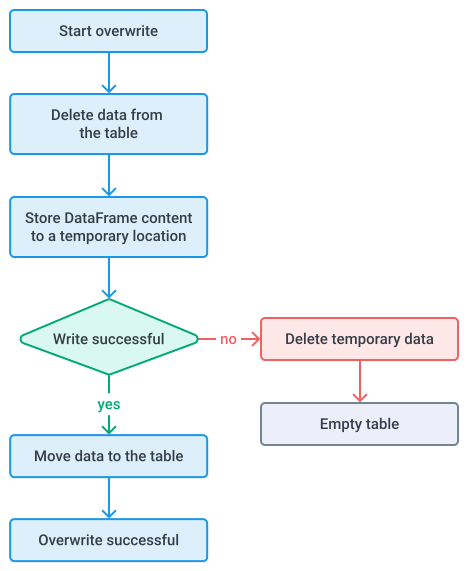
Если установлено значение spark.sql.hive.convertMetastoreOrc=true, при перезаписи возможны периодические потери данных из-за особенностей реализации протокола коммита, используемого в Spark по умолчанию.
Алгоритм работы стандартного протокола коммита изображен на следующей схеме.
OverwriteOnCommitProtocol
Чтобы избежать такого поведения и настроить Spark на выполнение перезаписи только после успешной записи DataFrame во временную директорию, необходимо использовать специальную реализацию протокола коммита (OverwriteOnCommitProtocol).
Существует несколько способов активации этого протокола, которые описаны ниже.
Используя ADCM, укажите следующий параметр в Custom spark-defaults.conf (Clusters → <ADHclusterName> → Services → Spark3 → Primary configuration) и перезапустите сервис Spark3:
spark.sql.sources.commitProtocolClass=org.apache.spark.sql.execution.datasources.OverwriteOnCommitProtocolЭто позволяет Spark использовать OverwriteOnCommitProtocol по умолчанию для всех задач.
Чтобы активировать протокол для конкретной задачи, укажите конфигурационный параметр при запуске spark-submit:
$ spark-submit
    --conf spark.sql.sources.commitProtocolClass=org.apache.spark.sql.execution.datasources.OverwriteOnCommitProtocol
    ..
Протокол можно явно указать при создании объекта SparkSession в коде PySpark:
from pyspark.sql import SparkSession

spark = SparkSession.builder \
.appName("MyApp") \
.config("spark.sql.sources.commitProtocolClass", "org.apache.spark.sql.execution.datasources.OverwriteOnCommitProtocol") \
.config("spark.sql.hive.convertMetastoreOrc", "true") \
.config("spark.sql.hive.convertMetastoreParquet", "true") \
.enableHiveSupport() \
.getOrCreate()
Требования и рекомендации
При использовании OverwriteOnCommitProtocol стоит учитывать следующее:
-
Убедитесь, что значение
spark.hadoop.mapreduce.fileoutputcommitter.algorithm.versionравно1(значение по умолчанию). -
Не рекомендуется использование с объектными хранилищами S3 из-за низкой скорости работы.