Конференция Arenadata
ArenaTech 2026 – для всех, кому интересны технологии Big Data
Приглашаем вас принять участие в технической онлайн-конференции, посвященной работе с большими данными. Участие бесплатно для всех желающих.

В программе 3 блока докладов:

  • СУБД: архитектура и эксплуатация. Обсудим новые возможности Greengage DB и Arenadata DB на его основе, включая hot standby, обзор утилиты изменения кластерной топологии ggrebalance, вопросы безопасности и устранения CVE.
  • Платформа данных: безопасность и Kubernetes в ADH, аналитика в ADQM. Расскажем об управлении секретами и доступом в Arenadata Hyperwave с использованием OpenBao, особенности переноса сервисов в Kubernetes, а также про аналитические методы в инструментах ADQM.
  • Инструменты: кластерный менеджер, документация, ИИ-поиск. Поделимся опытом разработки технической документации (включая интеллектуальный поиск и ИИ-ассистент) и поговорим про развитие нашего кластерного менеджера ADCM.
Онлайн-конференция состоится 29 октября 2026 года, время трансляции: с 12:00 до 19:00 по московскому времени.
Осталось до события

Создание заметки Solr

ПРИМЕЧАНИЕ
  • Перед созданием заметки убедитесь, что интерпретатор Solr настроен, как показано в статье Установка стороннего интерпретатора.

  • В этой статье используется Solr-коллекция people_ages, которая содержит имена и возраст 1000 человек. Dataset для коллекции доступен по прямой ссылке.

  1. В веб-интерфейсе Zeppelin кликните Create new note или выберите пункт основного меню Notebook → Create new note.
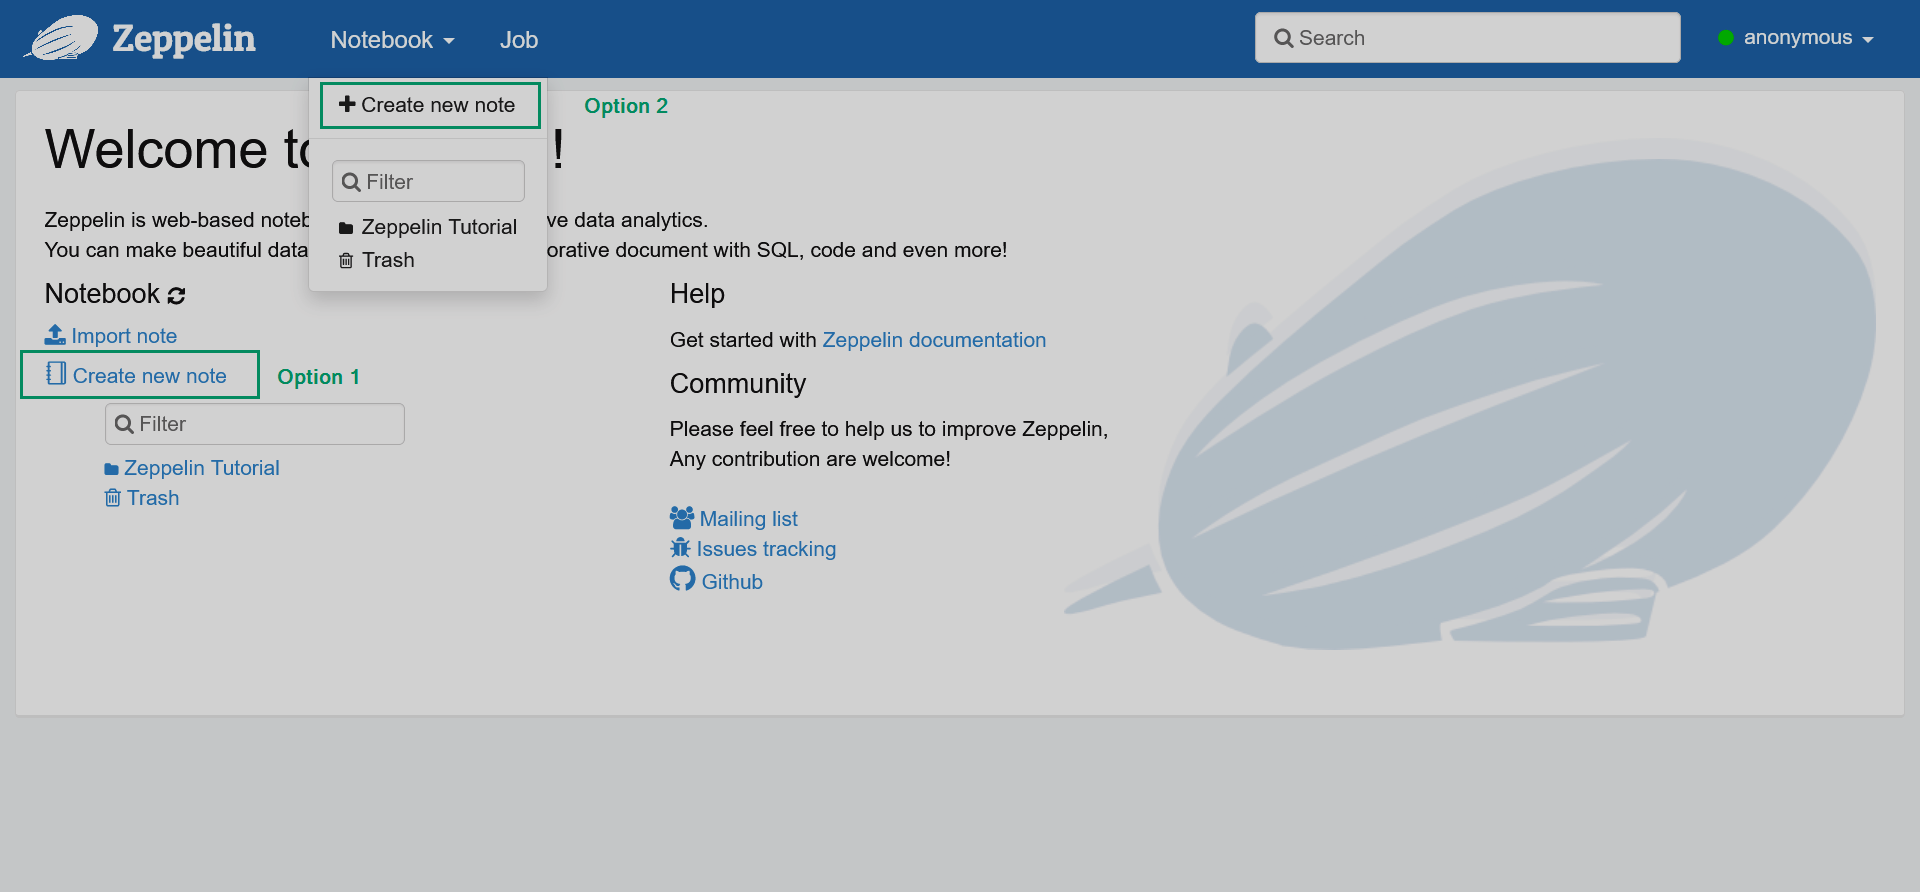
    Добавление новой заметки
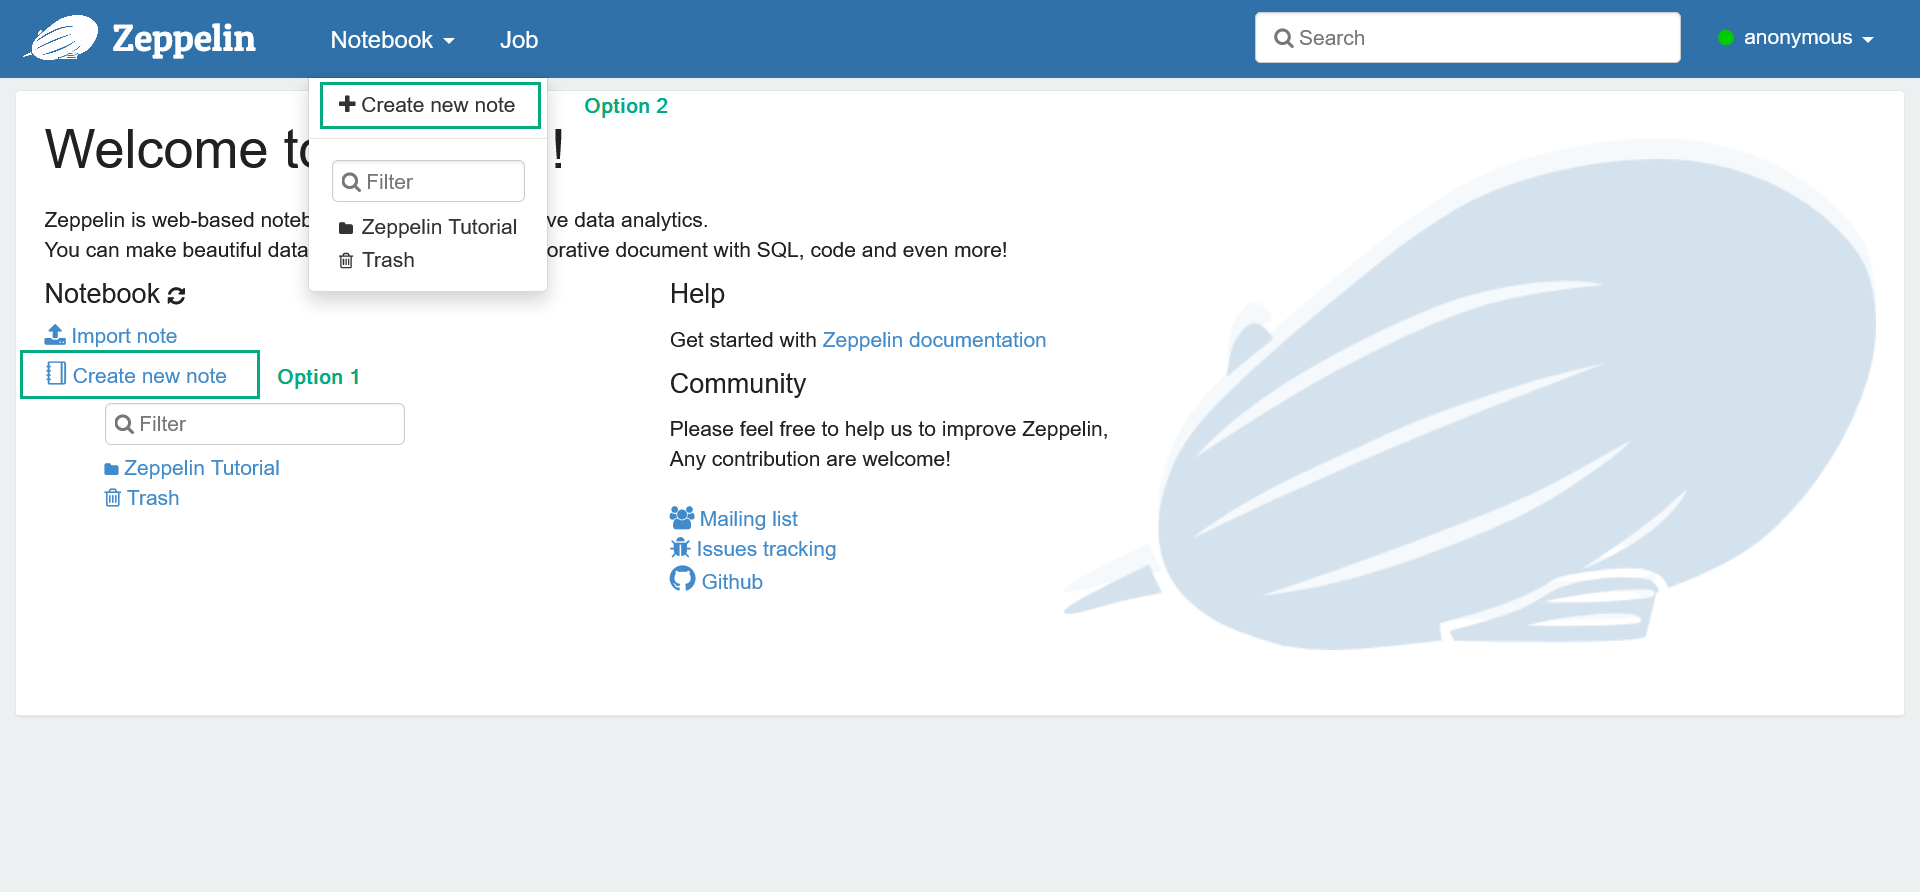
    Добавление новой заметки
    Добавление новой заметки
    Добавление новой заметки
  2. В открывшемся диалоге введите имя и укажите интерпретатор по умолчанию, который будет использован в случаях, когда явно не указан тип интерпретатора. Обратите внимание, что вы можете создавать папки для ваших заметок. Затем кликните Create.

Описание новой заметки
  1. В открывшемся окне кликните Interpreter binding, чтобы увидеть доступные интерпретаторы.

    Переход к сопоставлению интерпретаторов
    Переход к сопоставлению интерпретаторов
    Переход к сопоставлению интерпретаторов
    Переход к сопоставлению интерпретаторов
  2. Убедитесь, что интерпретатор %solr выбран в открывшемся списке; в противном случае — выберите его. Затем кликните Save.

    Сохранение интерпретатора
    Сохранение интерпретатора
    Сохранение интерпретатора
    Сохранение интерпретатора
  3. В первом разделе вашей заметки введите команду, которая выбирает коллекцию по умолчанию для выборки из Solr. Чтобы выполнить код, кликните Run this paragraph.

    use people_ages
    Установка Solr-коллекции по умолчанию
    Установка Solr-коллекции по умолчанию
    Установка Solr-коллекции по умолчанию
    Установка Solr-коллекции по умолчанию
    РЕКОМЕНДАЦИЯ
    Если не указать имя интерпретатора, по умолчанию используется имя %solr.
  4. Во втором разделе введите следующий запрос. Он возвращает количество людей, сгруппированных по возрасту.

    facet q=*:*&facet=true&facet.field=Age

    Результат приведен ниже.

    Таблица с результатами
    Таблица с результатами
    Таблица с результатами
    Таблица с результатами
  5. Кликните иконку Bar Chart, чтобы изменить вид результатов.

    Столбчатая диаграмма
    Столбчатая диаграмма
    Столбчатая диаграмма
    Столбчатая диаграмма
  6. Вы также можете использовать SQL-выражения. Введите следующий код в третьем разделе:

    SELECT MIN(Age) AS Minimum, MAX(Age) AS Maximum FROM people_ages

    Запрос возвращает минимальные и максимальные значения возрастов.

    Выполнение SQL-запроса
    Выполнение SQL-запроса
    Выполнение SQL-запроса
    Выполнение SQL-запроса
Нашли ошибку? Выделите текст и нажмите Ctrl+Enter чтобы сообщить о ней