

Архитектура StarRocks
StarRocks — это распределенная аналитическая база данных, предназначенная для высокопроизводительной обработки SQL-запросов. Она использует архитектуру массово-параллельной обработки (Massively Parallel Processing, MPP). При этом запрос разбивается на несколько подзапросов, которые одновременно обрабатываются несколькими вычислительными узлами.
В ADH StarRocks развертывается с использованием архитектуры shared-data. Эта архитектура подразумевает разделение обработки запросов и хранения постоянных данных: данные хранятся во внешнем хранилище, а вычислительные узлы StarRocks только обрабатывают запросы.
|
ВАЖНО
Модель shared-nothing и узлы Backend (BE) недоступны при установке сервиса StarRocks в ADH. В ADH используется только модель shared-data с компонентами FE и CN.
|
Кластер StarRocks в ADH состоит из следующих компонентов:
-
Frontend (FE) — управляет метаданными, принимает клиентские соединения, создает и оптимизирует планы выполнения запросов и координирует их исполнение.
-
Compute Node (CN) — выполняет фрагменты запросов и может кешировать данные.
Основные возможности
Такой подход предоставляет следующие возможности:
-
Массово-параллельное выполнение запросов. Рабочие нагрузки запросов распределяются между несколькими узлами CN и обрабатываются одновременно.
-
Полностью векторизированный вычислительный движок. Данные хранятся и обрабатываются в колоночном формате, что позволяет использовать процессорные мощности эффективнее.
-
Эластичное масштабирование вычислений. Узлы CN можно добавлять или удалять без перераспределения данных между вычислительными узлами.
-
Локальное кеширование данных. Узлы CN могут кешировать часто используемые данные — это позволяет сократить число обращений к внешнему хранилищу.
-
SQL-интерфейс. StarRocks поддерживает протокол MySQL, по которому стандартные SQL-клиенты и аналитические инструменты могут подключаться к кластеру.
-
Оптимизация запросов. Узлы FE используют анализатор на основе стоимости (Cost-Based Optimizer, CBO) для проверки SQL-инструкций и составления планов выполнения, оптимизированных для распределенной обработки.
-
Высокая доступность. Можно развернуть несколько узлов FE, чтобы обеспечить избыточность метаданных и непрерывность работы сервиса.
-
Изоляция ресурсов. Ресурсами хранения и вычисления можно управлять независимо, что особенно полезно для рабочих нагрузок с меняющимися требованиями к вычислительным ресурсам.
Обзор архитектуры
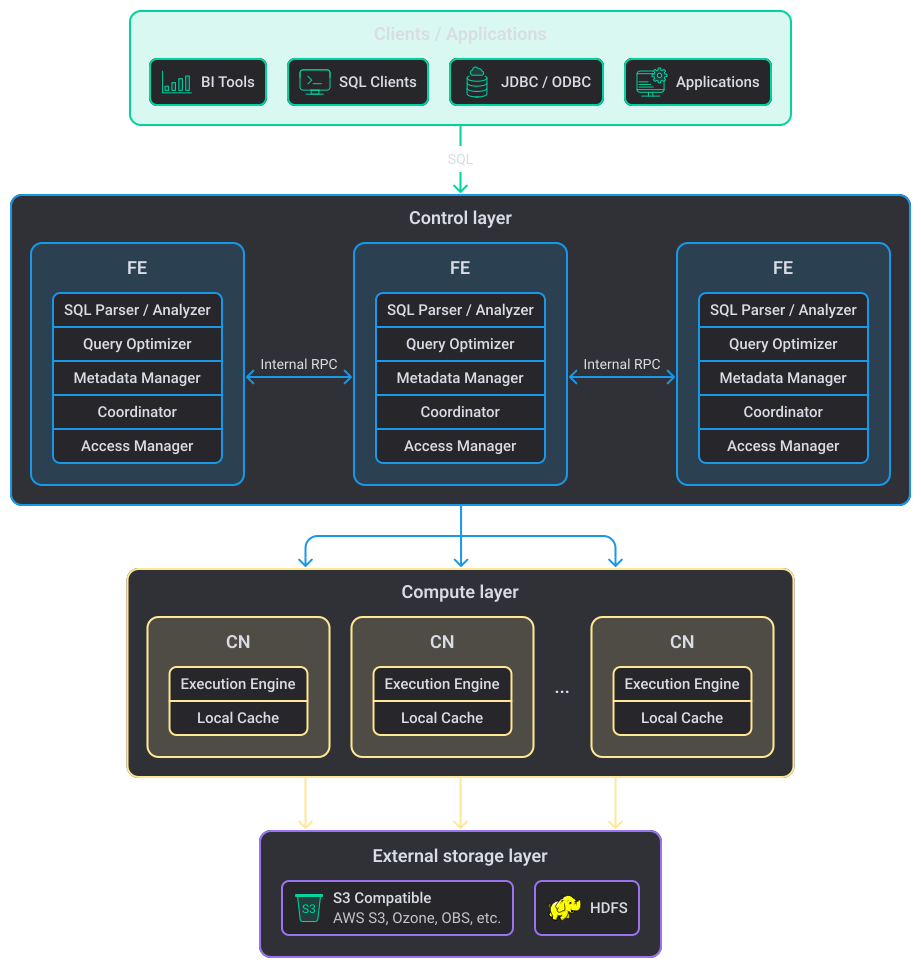
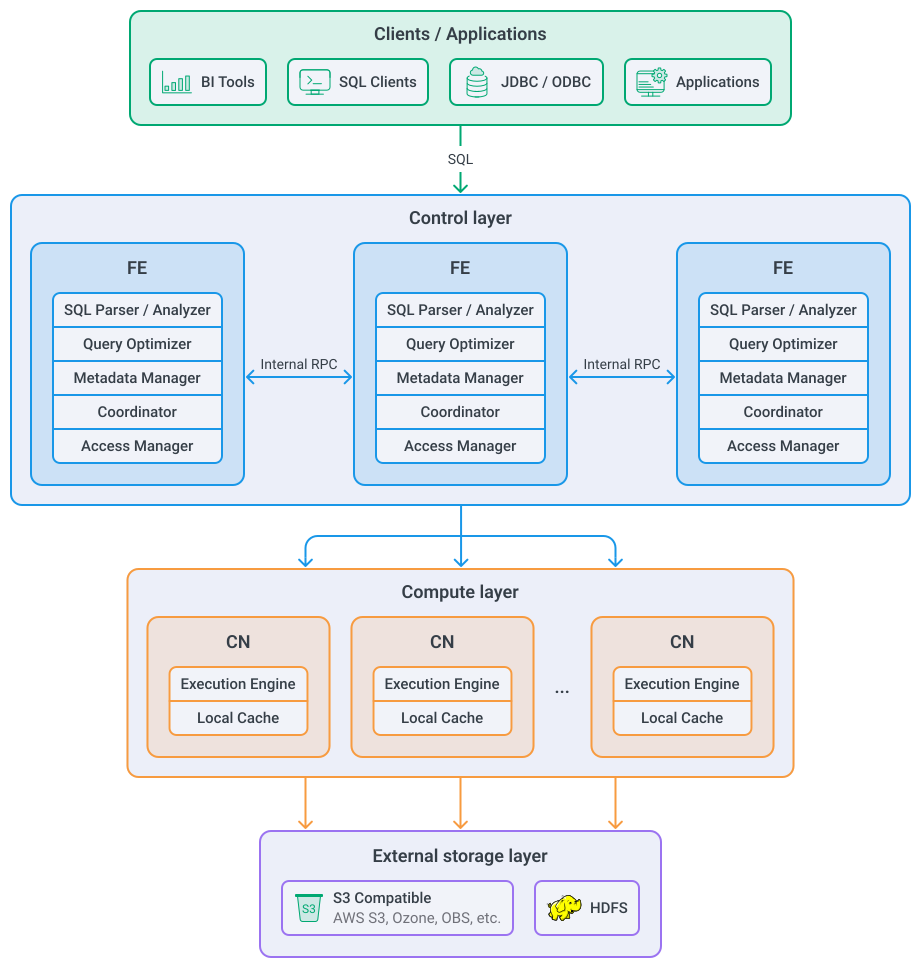
StarRocks представляет слои управления и вычислений в логической схеме выполнения SQL-запроса:
-
Клиентский слой. SQL-клиенты, BI-приложения и другие приложения, отправляющие запросы в StarRocks.
-
Слой управления. Компоненты FE, управляющие метаданными и формирующие планы запросов.
-
Вычислительный слой. Компоненты CN, выполняющие рабочие нагрузки.
-
Слой хранения. Внешнее хранилище, содержащее постоянные данные StarRocks.
Frontend (FE)
Frontend (FE) — это компонент, представляющий собой уровень управления StarRocks. Он координирует работу кластера и управляет метаданными, необходимыми для обработки SQL-запросов.
Основные задачи FE:
-
Управление метаданными кластера и баз данных.
-
Прием клиентских соединений.
-
Управление сессиями клиентов.
-
Синтаксический разбор SQL-выражений.
-
Создание логических планов запросов.
-
Оптимизация запросов.
-
Формирование физических планов выполнения запросов.
-
Планирование выполнения запросов.
-
Координация распределенной обработки запросов.
Каждый узел FE локально хранит копию метаданных StarRocks. Для повышения доступности и распределения нагрузки можно развернуть несколько узлов FE.
Каждый из узлов FE имеет свою роль.
-
Leader — выполняет операции записи метаданных и координирует изменения метаданных.
-
Follower — поддерживает синхронизированную копию метаданных и участвует в выборе лидера.
-
Observer — хранит копию метаданных лидера и может увеличивать пропускную способность слоя FE по обслуживанию запросов, но не участвует в выборе лидера.
Если текущий лидер становится недоступен, узлы Follower FE могут выбрать нового лидера с использованием механизма репликации метаданных на основе Raft.
С точки зрения обработки запросов FE отвечает за определение способа выполнения запроса. Сам FE не выполняет обработку данных. Вместо этого он создает план выполнения и распределяет соответствующие задачи между узлами CN.
Compute Node (CN)
Compute Node (CN) — основной компонент выполнения сервиса StarRocks. Узлы CN отвечают за исполнение физического плана запроса, созданного FE. Они производят такие операции, как:
-
Сканирование данных.
-
Фильтрация записей.
-
Объединение наборов данных.
-
Агрегация результатов.
-
Сортировка данных.
-
Выполнение выражений и функций.
-
Обмен промежуточными данными с другими узлами CN.
-
Кеширование часто используемых данных.
Узлы CN используются при установке согласно модели shared-data, они не хранят постоянные данные.
Внешнее хранилище
В ADH StarRocks поддерживает HDFS и Ozone в качестве внешних хранилищ данных. Если установлены и HDFS, и Ozone, в качестве внешнего хранилища по умолчанию выбирается HDFS.
StarRocks можно настроить для использования других объектных хранилищ, таких как S3-совместимые системы, GCS или Azure.
Взаимодействие компонентов
Обработка запросов
Компоненты FE и CN вместе выполняют обработку запросов.
Типичный жизненный цикл запроса состоит из следующих этапов:
-
Подключение клиента. Клиентское приложение отправляет SQL-инструкцию на узел FE. FE становится точкой входа для запроса и координирует последующую обработку.
-
Синтаксический разбор и анализ SQL. FE разбирает SQL-инструкцию и проверяет запрошенную операцию на основе доступных метаданных. Он определяет используемые таблицы и столбцы, анализирует условия фильтрации и требуемую агрегацию.
-
Оптимизация запроса. FE создает и проверяет план запроса. Оптимизатор определяет, как запрошенные операции могут быть эффективно выполнены в кластере CN. Полученный физический план состоит из фрагментов выполнения, которые могут быть распределены между узлами CN.
-
Планирование выполнения запроса. FE составляет план выполнения фрагментов запроса на доступных узлах CN.
-
Доступ к данным. Когда CN начинает выполнять фрагмент запроса, он получает доступ к необходимым данным. Данные могут уже находиться в локальном кеше. Если данных в кеше нет, CN получает необходимые данные из внешнего хранилища.
-
Распределенное выполнение. Узлы CN параллельно выполняют порученные им фрагменты запроса. Отдельные CN могут одновременно обрабатывать разные части запроса.
-
Обмен промежуточными данными. Некоторые операции требуют от узлов CN обмена промежуточными результатами. Это типично для распределенных операций объединения и агрегации.
-
Возврат результата. После выполнения необходимых фрагментов FE координирует возврат результата выполнения фрагментов запроса клиенту.
Загрузка данных
Узлы FE и CN также взаимодействуют при загрузке данных в StarRocks:
-
FE получает запрос на загрузку данных и координирует его выполнение. Он определяет соответствующую стратегию выполнения и назначает рабочую нагрузку узлам CN.
-
Узлы CN выполняют обработку данных в рамках операции загрузки и записывают полученные постоянные данные во внешний слой хранения.
Масштабирование
Одним из основных преимуществ архитектуры shared-data является возможность независимо масштабировать вычислительный слой.
При увеличении количества параллельных запросов или требований к вычислительным ресурсам в кластер можно добавить дополнительные узлы CN. Поскольку постоянные данные хранятся во внешнем хранилище, добавление CN не требует перемещения существующих данных между вычислительными узлами.
Такое разделение особенно полезно, когда требования к объему хранения и обработке запросов растут с разной скоростью.
Высокая доступность
Высокая доступность StarRocks может быть обеспечена на всех функциональных слоях:
-
Доступность FE. Для обеспечения доступности метаданных можно развернуть несколько узлов FE. Узлы Observer FE реплицируют метаданные, а узлы Follower участвуют в выборе лидера. Если активный лидер выходит из строя, другой подходящий узел Follower может стать новым лидером.
-
Доступность CN. Если узел CN становится недоступным, другой доступный CN может начать обрабатывать последующую рабочую нагрузку. Доступность CN влияет на вычислительную емкость кластера. Поэтому количество узлов CN следует планировать с учетом ожидаемого количества параллельных запросов и требований рабочих нагрузок.
-
Доступность хранилища. Постоянные данные хранятся во внешней системе хранения. Доступность, надежность, емкость и производительность этой системы хранения влияет на общие характеристики сервиса StarRocks.