

Настройка производительности StarRocks
Инструменты для настройки производительности
Настройка запросов в StarRocks обычно начинается с анализа того, как планируется запрос, затем проверяется, как он фактически выполняется, и после этого анализируются подробные runtime-метрики для поиска узких мест. В данной статье описаны основные инструменты, используемые в этом процессе:
-
EXPLAIN — показывает план выполнения, созданный оптимизатором, до запуска запроса.
-
EXPLAIN ANALYZE — запускает запрос и добавляет в план выполнения фактическую runtime-статистику.
-
Профиль запроса — предоставляет подробные runtime-метрики для завершенных или выполняющихся запросов.
Более подробную информацию можно найти в документации StarRocks.
Основные термины
В статье используются следующие термины:
-
Оператор — шаг в плане выполнения запроса, например сканирование данных, соединение наборов данных, агрегация строк, сортировка результатов или обмен данными между узлами.
-
Предикат — условие фильтрации, например условие из конструкции
WHERE. -
Пушдаун (pushdown) предикатов — применение предиката как можно раньше, обычно во время сканирования данных, чтобы уменьшить объем данных, обрабатываемых последующими операторами.
-
Кардинальность (cardinality) — оценочное или фактическое количество строк, обрабатываемых или создаваемых оператором.
-
Стоимость (cost) — оценка оптимизатором ресурсов, необходимых для выполнения операции. Оценки стоимости могут включать оценки CPU, памяти, сети и количества строк.
-
Партиция (partition) — логический раздел таблицы, который объединяет данные по определенному признаку, например по времени или датам. Отсечение партиций позволяет StarRocks пропускать партиции, которые не требуются для запроса.
-
Таблет (tablet) — это микро-партиция: минимальный элемент хранения и репликации данных, который распределяется по узлам хранения.
-
Exchange — оператор, который передает промежуточные данные между вычислительными узлами. В зависимости от плана данные могут распределяться с помощью операции shuffle, broadcast или gather.
EXPLAIN
Команда EXPLAIN показывает план выполнения, созданный оптимизатором StarRocks для SQL-команд, без ее запуска. Используйте ее перед выполнением, чтобы понять, как запланировано выполнение операторов SCAN, JOIN, AGGREGATE, предикатов и обменов данными. Более подробную информацию можно найти в документации StarRocks.
StarRocks поддерживает несколько режимов EXPLAIN:
-
EXPLAIN LOGICAL— показывает упрощенный логический план. -
EXPLAIN— показывает базовый физический план. -
EXPLAIN VERBOSE— показывает физический план с подробной информацией. -
EXPLAIN COSTS— показывает оценочные стоимости операций плана. Этот режим полезен для диагностики проблем, связанных со статистикой таблиц и столбцов.
Пример запроса, расположенный ниже, находит возрастные группы пользователей, на которые приходится наибольшее количество покупок:
EXPLAIN
SELECT u.age, count(e.event_id) AS total_events
FROM user_events e
JOIN users u ON e.user_id = u.user_id
WHERE e.event_type = 'purchase'
GROUP BY u.age
ORDER BY total_events DESC;
Вывод содержит дерево операторов, которое представляет поток выполнения запроса. Читайте план снизу вверх: начните с операторов сканирования данных и двигайтесь по дереву к итоговому результату.
+-----------------------------------------------------------------------+
| Explain String                                                        |
+-----------------------------------------------------------------------+
| PLAN FRAGMENT 0                                                       |
|  OUTPUT EXPRS:6: age | 8: count                                       |
|   PARTITION: UNPARTITIONED                                            |
|                                                                       |
|   RESULT SINK                                                         |
|                                                                       |
|   10:MERGING-EXCHANGE                                                 |
|                                                                       |
| PLAN FRAGMENT 1                                                       |
|  OUTPUT EXPRS:                                                        |
|   PARTITION: HASH_PARTITIONED: 6: age                                 |
|                                                                       |
|   STREAM DATA SINK                                                    |
|     EXCHANGE ID: 10                                                   |
|     UNPARTITIONED                                                     |
|                                                                       |
|   9:SORT                                                              |
|   |  order by: <slot 8> 8: count DESC                                 |
|   |  offset: 0                                                        |
|   |                                                                   |
|   8:AGGREGATE (merge finalize)                                        |
|   |  output: count(8: count)                                          |
|   |  group by: 6: age                                                 |
|   |                                                                   |
|   7:EXCHANGE                                                          |
|                                                                       |
| PLAN FRAGMENT 2                                                       |
|  OUTPUT EXPRS:                                                        |
|   colocate exec groups: ExecGroup{groupId=3, nodeIds=[0, 1, 4, 5, 6]} |
|   PARTITION: RANDOM                                                   |
|                                                                       |
|   STREAM DATA SINK                                                    |
|     EXCHANGE ID: 07                                                   |
|     HASH_PARTITIONED: 6: age                                          |
|                                                                       |
|   6:AGGREGATE (update serialize)                                      |
|   |  STREAMING                                                        |
|   |  output: count(1: event_id)                                       |
|   |  group by: 6: age                                                 |
|   |                                                                   |
|   5:Project                                                           |
|   |  <slot 1> : 1: event_id                                           |
|   |  <slot 6> : 6: age                                                |
|   |                                                                   |
|   4:HASH JOIN                                                         |
|   |  join op: INNER JOIN (BUCKET_SHUFFLE)                             |
|   |  colocate: false, reason:                                         |
|   |  equal join conjunct: 2: user_id = 5: user_id                     |
|   |                                                                   |
|   |----3:EXCHANGE                                                     |
|   |                                                                   |
|   1:Project                                                           |
|   |  <slot 1> : 1: event_id                                           |
|   |  <slot 2> : 2: user_id                                            |
|   |                                                                   |
|   0:OlapScanNode                                                      |
|      TABLE: user_events                                               |
|      PREAGGREGATION: ON                                               |
|      PREDICATES: 3: event_type = 'purchase'                           |
|      partitions=1/1                                                   |
|      rollup: user_events                                              |
|      tabletRatio=4/4                                                  |
|      tabletList=81270,81271,81272,81273                               |
|      cardinality=333333                                               |
|      avgRowSize=21.667553                                             |
|                                                                       |
| PLAN FRAGMENT 3                                                       |
|  OUTPUT EXPRS:                                                        |
|   PARTITION: RANDOM                                                   |
|                                                                       |
|   STREAM DATA SINK                                                    |
|     EXCHANGE ID: 03                                                   |
|     BUCKET_SHUFFLE_HASH_PARTITIONED: 5: user_id                       |
|                                                                       |
|   2:OlapScanNode                                                      |
|      TABLE: users                                                     |
|      PREAGGREGATION: ON                                               |
|      partitions=1/1                                                   |
|      rollup: users                                                    |
|      tabletRatio=4/4                                                  |
|      tabletList=81262,81263,81264,81265                               |
|      cardinality=10000                                                |
|      avgRowSize=12.0                                                  |
+-----------------------------------------------------------------------+
83 rows in set (0.09 sec)
При анализе вывода EXPLAIN обращайте внимание на следующие области:
-
Операторы
SCAN— определите, какие таблицы, партиции и таблеты сканируются, и проверьте, выполняется ли pushdown предикатов. В примереOlapScanNodeдля таблицыuser_eventsприменяет предикатevent_type = 'purchase'во время сканирования. -
Операторы
JOIN— проверьте порядок соединений, тип соединения, стратегию соединения и условия соединения. В примере StarRocks использует операторHASH JOINсо стратегией распределенияBUCKET_SHUFFLE. -
Операторы
AGGREGATE— определите, где выполняются этапы частичной и финальной агрегации. В примере этапupdate serializeявляется этапом частичной агрегации, а этапmerge finalize— этапом финальной агрегации. -
Операторы
EXCHANGE— ищите перемещение данных между узлами, включая операции shuffle, broadcast и gather. В примере операторыEXCHANGEперераспределяют промежуточные результаты между фрагментами плана. -
Оценки кардинальности — проверьте, реалистичны ли оценки количества строк.
Если план не соответствует ожиданиям, начните с изменений на уровне запроса: перепишите запрос, добавьте фильтры раньше, скорректируйте условия соединения или обновите статистику. Если этих изменений недостаточно, изучите настройку схемы или рассмотрите подсказки запросов.
EXPLAIN ANALYZE
Команда EXPLAIN ANALYZE запускает запрос и отображает фактический план выполнения вместе с runtime-статистикой. В отличие от EXPLAIN, она предоставляет реальную информацию о выполнении, например время на уровне операторов, количество строк и использование ресурсов. Используйте ее, когда логический план выглядит приемлемым, но запрос все еще выполняется медленно.
StarRocks поддерживает EXPLAIN ANALYZE для команд SELECT и INSERT INTO. Для команд INSERT INTO StarRocks может проанализировать профиль запроса без фактической загрузки данных. Это поддерживается для внутренних таблиц в каталоге default_catalog. В этом режиме StarRocks анализирует запрос, но автоматически отменяет операцию загрузки, чтобы предотвратить непреднамеренные изменения данных. Более подробную информацию можно найти в документации StarRocks.
Синтаксис:
EXPLAIN ANALYZE <sql_statement>;Пример:
EXPLAIN ANALYZE
SELECT u.age, count(e.event_id) AS total_events
FROM user_events e
JOIN users u ON e.user_id = u.user_id
WHERE e.event_type = 'purchase'
GROUP BY u.age
ORDER BY total_events DESC;+--------------------------------------------------------------------------------------------------------------------------------------------------------------+ | Explain String | +--------------------------------------------------------------------------------------------------------------------------------------------------------------+ | Summary | | QueryId: 01a0c3d7-f4fc-73b7-b233-d679d08c631e | | Version: 4.0.10.1-4.4.0-0-fd9add6 | | State: Finished | | TotalTime: 63ms | | ExecutionTime: 24.368ms [Scan: 6.170ms (25.32%), Network: 6.923ms (28.41%), ResultDeliverTime: 0ns (0.00%), ScheduleTime: 22.641ms (92.91%)] | | CollectProfileTime: 5ms | | FrontendProfileMergeTime: 15.092ms | | QueryPeakMemoryUsage: ?, QueryAllocatedMemoryUsage: 35.019 MB | | Top Most Time-consuming Nodes: | | 1. HASH_JOIN (id=4) [BUCKET_SHUFFLE, INNER JOIN]: 7.017ms (29.78%) | | 2. OLAP_SCAN (id=0) : 6.246ms (26.51%) | | 3. EXCHANGE (id=7) [SHUFFLE]: 4.980ms (21.14%) | | 4. EXCHANGE (id=3) [SHUFFLE]: 1.706ms (7.24%) | | 5. MERGE_EXCHANGE (id=10) [GATHER]: 1.430ms (6.07%) | | 6. OLAP_SCAN (id=2) : 1.068ms (4.53%) | | 7. AGGREGATION (id=6) [serialize, update]: 605.244us (2.57%) | | 8. SORT (id=9) [ROW_NUMBER, SORT]: 162.046us (0.69%) | | 9. AGGREGATION (id=8) [finalize, merge]: 141.763us (0.60%) | | 10. RESULT_SINK: 100.992us (0.43%) | | Top Most Memory-consuming Nodes: | | NonDefaultVariables: | | enable_adaptive_sink_dop: false -> true | | enable_async_profile: true -> false | | enable_profile: false -> true | | Fragment 0 | | │ BackendNum: 1 | | │ InstancePeakMemoryUsage: 66.227 KB, InstanceAllocatedMemoryUsage: 162.500 KB | | │ PrepareTime: ? | | └──RESULT_SINK | | │ TotalTime: 100.992us (0.43%) [CPUTime: 100.992us] | | │ OutputRows: 60 | | │ SinkType: MYSQL_PROTOCAL | | └──MERGE_EXCHANGE (id=10) [GATHER] | | Estimates: [row: 60, cpu: 720.00, memory: 720.00, network: 720.00, cost: 11940955.65] | | TotalTime: 1.430ms (6.07%) [CPUTime: 329.854us, NetworkTime: 1.100ms] | | OutputRows: 60 | | PeakMemory: ?, AllocatedMemory: ? | | | | Fragment 1 | | │ BackendNum: 3 | | │ InstancePeakMemoryUsage: 739.049 KB, InstanceAllocatedMemoryUsage: 2.763 MB | | │ PrepareTime: ? | | └──DATA_STREAM_SINK (id=10) | | │ PartitionType: UNPARTITIONED | | └──SORT (id=9) [ROW_NUMBER, SORT] | | │ Estimates: [row: 60, cpu: 720.00, memory: 720.00, network: 720.00, cost: 11938075.65] | | │ TotalTime: 162.046us (0.69%) [CPUTime: 162.046us] | | │ OutputRows: 60 | | │ PeakMemory: ?, AllocatedMemory: ? | | │ OrderByExprs: [<slot 8> 8: count] | | └──AGGREGATION (id=8) [finalize, merge] | | │ Estimates: [row: 60, cpu: 720.00, memory: 720.00, network: 0.00, cost: 11935195.65] | | │ TotalTime: 141.763us (0.60%) [CPUTime: 141.763us] | | │ OutputRows: 60 | | │ PeakMemory: ?, AllocatedMemory: ? | | │ AggExprs: [count(8: count)] | | │ GroupingExprs: [6: age] | | └──EXCHANGE (id=7) [SHUFFLE] | | Estimates: [row: 60, cpu: 72.00, memory: 0.00, network: 72.00, cost: 11933395.65] | | TotalTime: 4.980ms (21.14%) [CPUTime: 454.472us, NetworkTime: 4.526ms] | | OutputRows: 720 | | PeakMemory: ?, AllocatedMemory: ? | | Detail Timers: | | OverallTime: 3.487ms [min=1.709ms, max=4.747ms] | | WaitTime: 3.334ms [min=1.538ms, max=4.624ms] | | | | Fragment 2 | | │ BackendNum: 3 | | │ InstancePeakMemoryUsage: 3.932 MB, InstanceAllocatedMemoryUsage: 29.957 MB | | │ PrepareTime: ? | | └──DATA_STREAM_SINK (id=7) | | │ PartitionType: HASH_PARTITIONED | | │ PartitionExprs: [6: age] | | └──AGGREGATION (id=6) [serialize, update] | | │ Estimates: [row: 60, cpu: 927305.85, memory: 72.00, network: 0.00, cost: 11933251.65] | | │ TotalTime: 605.244us (2.57%) [CPUTime: 605.244us] | | │ OutputRows: 720 | | │ PeakMemory: ?, AllocatedMemory: ? | | │ AggExprs: [count(1: event_id)] | | │ GroupingExprs: [6: age] | | │ SubordinateOperators: | | │ LOCAL_EXCHANGE [Passthrough] | | └──PROJECT (id=5) | | │ Estimates: [row: ?, cpu: ?, memory: ?, network: ?, cost: ?] | | │ TotalTime: 31.415us (0.13%) [CPUTime: 31.415us] | | │ OutputRows: 333.649K (333649) | | │ Expression: [1: event_id, 6: age] | | └──HASH_JOIN (id=4) [BUCKET_SHUFFLE, INNER JOIN] | | │ Estimates: [row: 331180, cpu: 14726391.79, memory: 120000.00, network: 0.00, cost: 11469454.73] | | │ TotalTime: 7.017ms (29.78%) [CPUTime: 7.017ms] | | │ OutputRows: 333.649K (333649) | | │ PeakMemory: ?, AllocatedMemory: ? | | │ BuildTime: 461.809us | | │ ProbeTime: 465.010us | | │ EqJoinConjuncts: [2: user_id = 5: user_id] | | │ SubordinateOperators: | | │ CHUNK_ACCUMULATE | | │ LOCAL_EXCHANGE [Partition(BUCKET_SHUFFLE_HASH_PARTITIONED)] | | ├──<PROBE> PROJECT (id=1) | | │ │ Estimates: [row: ?, cpu: ?, memory: ?, network: ?, cost: ?] | | │ │ TotalTime: 70.353us (0.30%) [CPUTime: 70.353us] | | │ │ OutputRows: 333.649K (333649) | | │ │ Expression: [1: event_id, 2: user_id] | | │ └──OLAP_SCAN (id=0) | | │ Estimates: [row: 333333, cpu: 7222517.67, memory: 0.00, network: 0.00, cost: 3611258.83] | | │ TotalTime: 6.246ms (26.51%) [CPUTime: 635.010us, ScanTime: 5.611ms] | | │ OutputRows: 333.649K (333649) | | │ RuntimeFilter: 333.649K (333649) -> 333.649K (333649) (0.00%) | | │ Table: : user_events | | │ SubordinateOperators: | | │ CHUNK_ACCUMULATE | | │ Detail Timers: [ScanTime = IOTaskExecTime + IOTaskWaitTime] | | │ IOTaskExecTime: 4.819ms [min=4.443ms, max=5.575ms] | | │ SegmentRead: 3.535ms [min=3.081ms, max=4.286ms] | | │ BlockFetch: 2.122ms [min=1.595ms, max=2.577ms] | | │ IOTaskWaitTime: 32.778us [min=25.964us, max=36.608us] | | └──<BUILD> EXCHANGE (id=3) [SHUFFLE] | | Estimates: [row: 10000, cpu: 120000.00, memory: 0.00, network: 120000.00, cost: 300000.00] | | TotalTime: 1.706ms (7.24%) [CPUTime: 409.628us, NetworkTime: 1.296ms] | | OutputRows: 10.000K (10000) | | PeakMemory: ?, AllocatedMemory: ? | | | | Fragment 3 | | │ BackendNum: 3 | | │ InstancePeakMemoryUsage: 315.516 KB, InstanceAllocatedMemoryUsage: 2.140 MB | | │ PrepareTime: ? | | └──DATA_STREAM_SINK (id=3) | | │ PartitionType: BUCKET_SHUFFLE_HASH_PARTITIONED | | │ PartitionExprs: [5: user_id] | | └──OLAP_SCAN (id=2) | | Estimates: [row: 10000, cpu: 120000.00, memory: 0.00, network: 0.00, cost: 60000.00] | | TotalTime: 1.068ms (4.53%) [CPUTime: 509.054us, ScanTime: 559.300us] | | OutputRows: 10.000K (10000) | | Table: : users | | | +--------------------------------------------------------------------------------------------------------------------------------------------------------------+ 136 rows in set (0.08 sec)
При анализе вывода EXPLAIN ANALYZE сначала изучите раздел Summary в начале профиля. Он содержит сводную информацию по всему запросу: идентификатор запроса, версию StarRocks, состояние выполнения, общее время выполнения, использование памяти и список операторов, которые заняли больше всего времени. В этом примере больше всего времени потребляют операторы HASH_JOIN, OLAP_SCAN и EXCHANGE, поэтому основные области для оптимизации — обработка соединений, сканирование таблиц и перераспределение данных.
После анализа Summary переходите к дереву операторов, которое начинается ниже, с разделов Fragment. В этой части вывода метрики уже относятся не ко всему запросу, а к отдельным операторам плана. Читайте дерево операторов снизу вверх: начните с операторов SCAN и проследите поток данных через JOIN, AGGREGATE, EXCHANGE, SORT и RESULT_SINK.
Для каждого оператора сравните оценки оптимизатора с runtime-метриками. Большие различия между оценочным и фактическим количеством строк могут указывать на то, что статистика оптимизатора устарела или отсутствует.
Обратите особое внимание на следующие метрики:
-
TotalTime— общее время, затраченное оператором. -
OutputRows— количество строк, созданных оператором. Сравните его сEstimates, чтобы оценить точность оценок кардинальности. -
CPUTime— время, затраченное на обработку CPU. -
ScanTime— время, затраченное на чтение данных в операторах сканирования. Высокие значения могут указывать на дорогие сканирования таблиц, недостаточное отсечение (pruning) или неэффективный pushdown предикатов. -
NetworkTime— время, затраченное на передачу данных между узлами. Высокие значения в операторахEXCHANGEмогут указывать на дорогое перераспределение данных. -
PeakMemoryиAllocatedMemory— использование памяти оператором, если доступно. Высокое использование памяти типично для соединений, агрегаций и сортировок.
В этом примере оператор OLAP_SCAN для таблицы user_events считывает около 333.649K строк, а оператор HASH_JOIN создает примерно такое же количество строк. Затем первая агрегация уменьшает результат до 720 строк перед перераспределением и финализацией данных. Это означает, что запрос сканирует и соединяет относительно большое количество строк, но агрегация значительно уменьшает размер промежуточного результата.
Для более глубокой runtime-диагностики после выполнения запроса используйте профиль запроса.
Профиль запроса
Профиль запроса предоставляет больше информации о выполнении запроса, чем EXPLAIN ANALYZE. Используйте профиль, когда нужна полная диагностика выполнения для завершенного или выполняющегося запроса, включая потребление памяти, передачу по сети, статистику сканирования и подробные метрики операторов. Более подробную информацию можно найти в документации StarRocks.
Для интерпретации профиля запроса и ускорения медленных запросов используйте рекомендации по настройке профиля запроса StarRocks, описанные в документации StarRocks.
По умолчанию профиль запроса отключен. Чтобы собирать профили для всех запросов в текущей сессии, выполните команду:
SET enable_profile = true;|
ПРИМЕЧАНИЕ
Выполнение команды |
После завершения запроса изучите его профиль одним из следующих способов:
-
В web UI StarRocks.
-
Вызвав SQL-функцию
get_query_profile:SELECT get_query_profile('<query_id>');где
<query_id>— идентификатор запроса, который нужно проанализировать, например01a0c845-2b07-781b-9907-2dc78f9b782d.
Более подробную информацию можно найти в документации StarRocks.
Web UI
Профиль запроса можно скачать на странице queries в web-интерфейсе StarRocks.
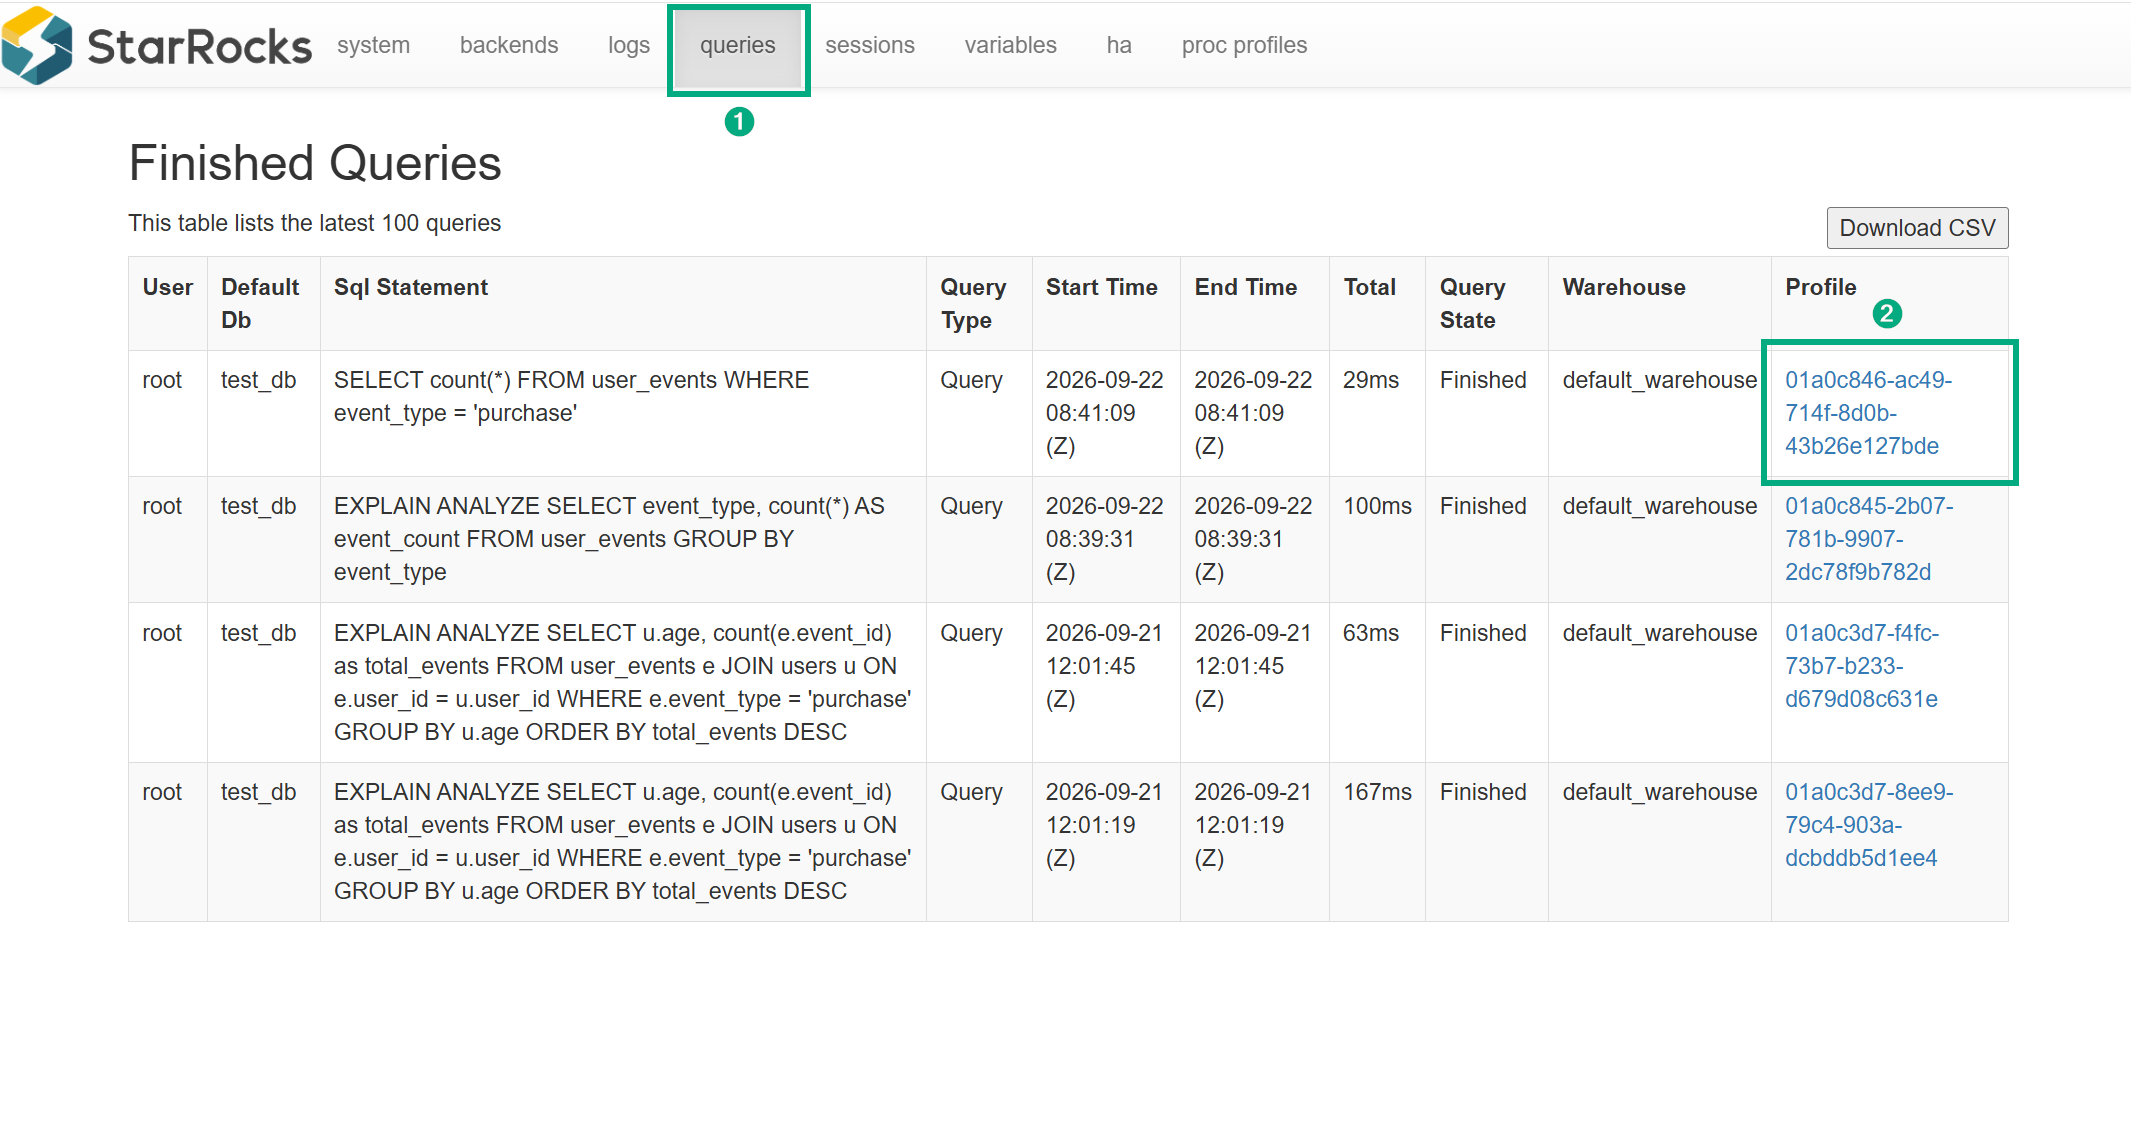
Более подробную информацию можно найти в документации StarRocks.
Настройка схемы
Если настройка на уровне запроса недостаточно повышает производительность, проверьте дизайн схемы. В StarRocks модель таблицы, ключ сортировки, стратегия распределения данных, разбиение на партиции и материализованные представления могут влиять на то, сколько данных сканируется, перемещается и агрегируется. Более подробную информацию можно найти в документации StarRocks.
Подсказки запросов
Подсказки запросов (query hint) — это директивы, влияющие на решения оптимизатора. Используйте подсказки осторожно: они могут улучшить конкретный план, но также могут сделать запросы менее адаптивными при изменении объема или распределения данных.
Типичные случаи использования подсказок:
-
Принудительное применение или исключение конкретной стратегии соединения.
-
Настройка поведения оптимизатора для известного распределения данных.
-
Тестирование альтернативных планов выполнения в процессе разработки.
Более подробную информацию можно найти в документации StarRocks.