Обзор ADH
Arenadata Hyperwave (ADH) — это универсальная гибридная платформа на основе компонентов с открытым исходным кодом и собственных разработок, предназначенная для хранения, обработки и анализа структурированных, полуструктурированных и неструктурированных данных любого масштаба.
Платформа поддерживает различные модели развертывания и управления данными, предоставляет широкий набор инструментов для построения Lakehouse-архитектур и экономически эффективных озер данных (Data Lake). Она позволяет осуществлять развертывание гибридно, объединять локальную и облачную инфраструктуру в рамках единой платформы данных.
Архитектурные принципы
-
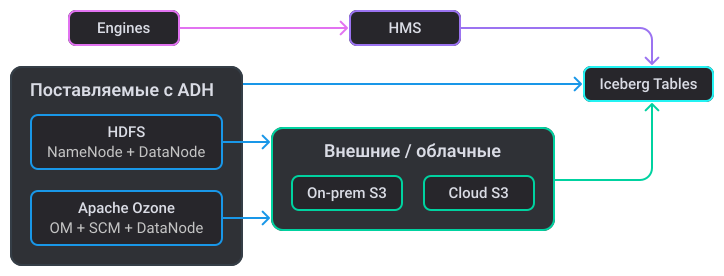
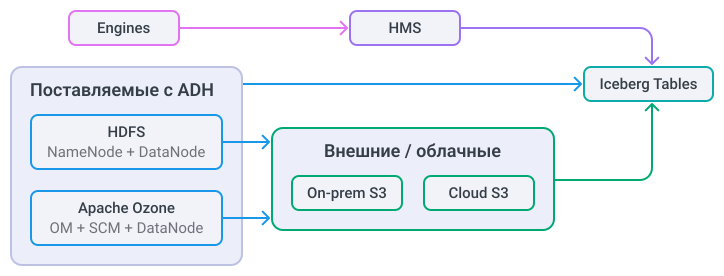
Слой хранения может использовать HDFS, Ozone, S3-совместимые хранилища и внешние облачные объектные хранилища.
-
Данные хранятся в открытых форматах, таких как Parquet, ORC и Avro.
-
Для управления таблицами могут использоваться открытые табличные форматы, такие как Apache Iceberg, и каталоги метаданных, такие как Apache Hive Metastore.
-
Несколько SQL, пакетных и потоковых движков обработки данных (Impala, Spark, Trino, Flink и другие) можно использовать для работы с одними и теми же наборами данных.
-
Вычислительные ресурсы и ресурсы хранения данных можно разделить для эластичного масштабирования либо разместить совместно для максимальной локальности данных.
-
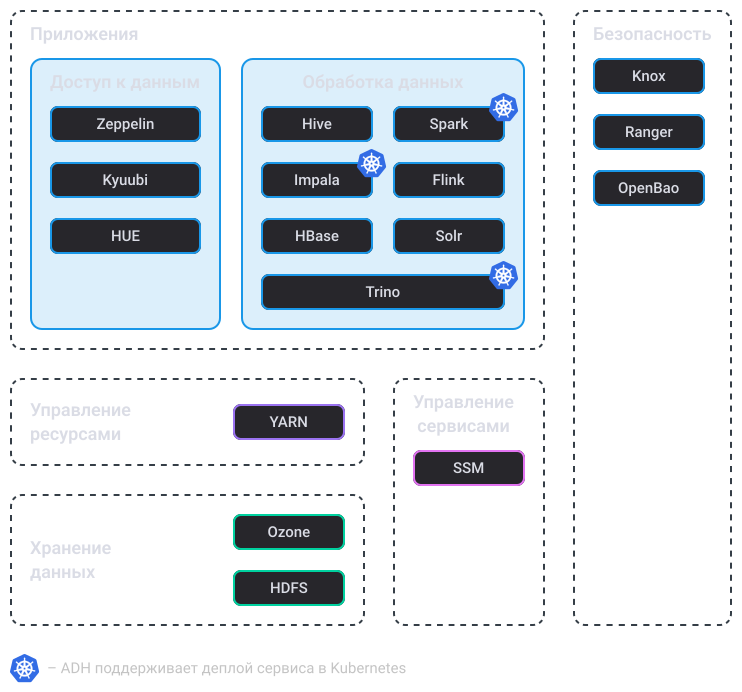
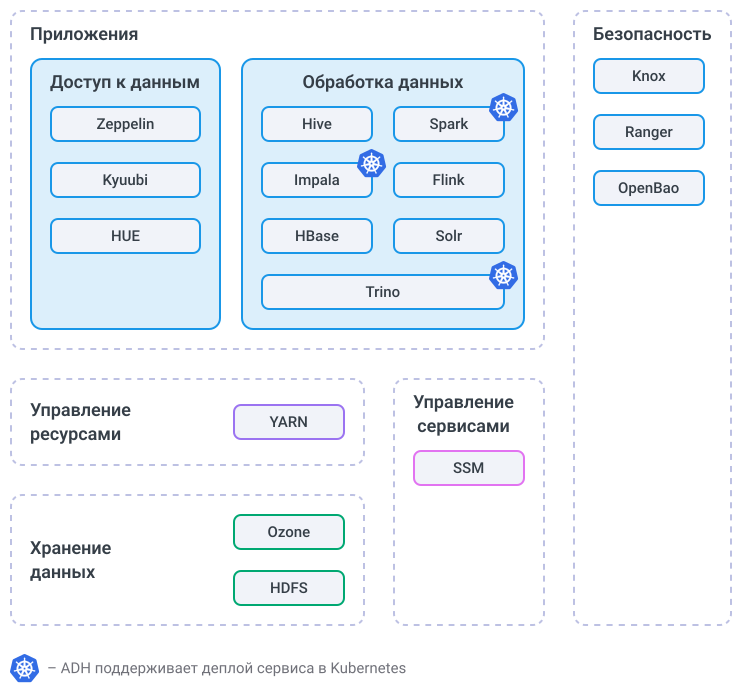
Можно развернуть вычислительные ресурсы в локальной инфраструктуре, Kubernetes или публичных облачных средах. В настоящий момент развертывание в Kubernetes доступно для сервисов Spark, Impala и Trino.
-
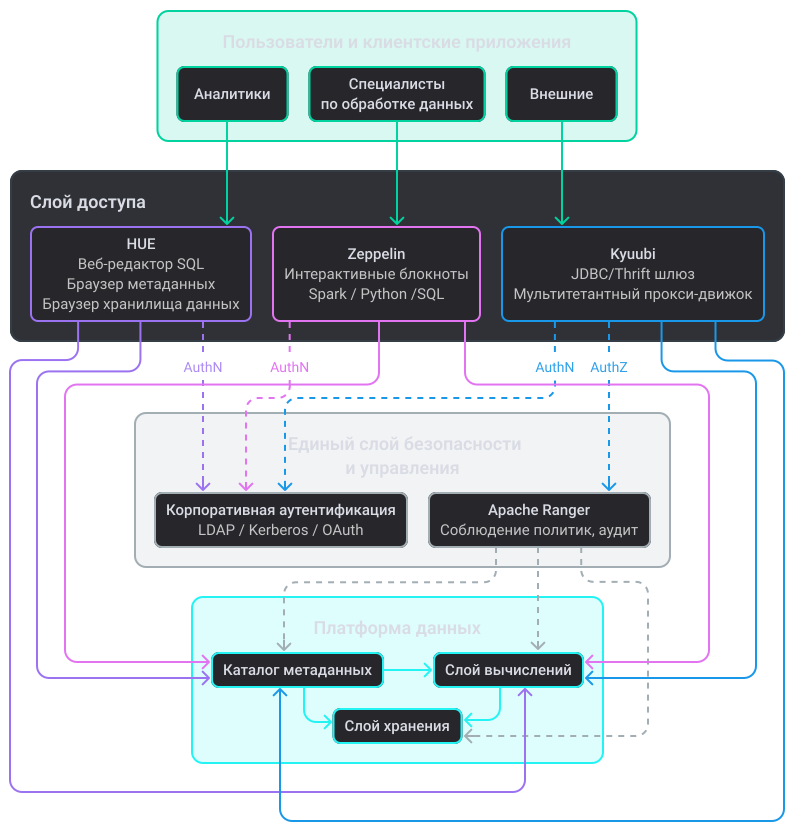
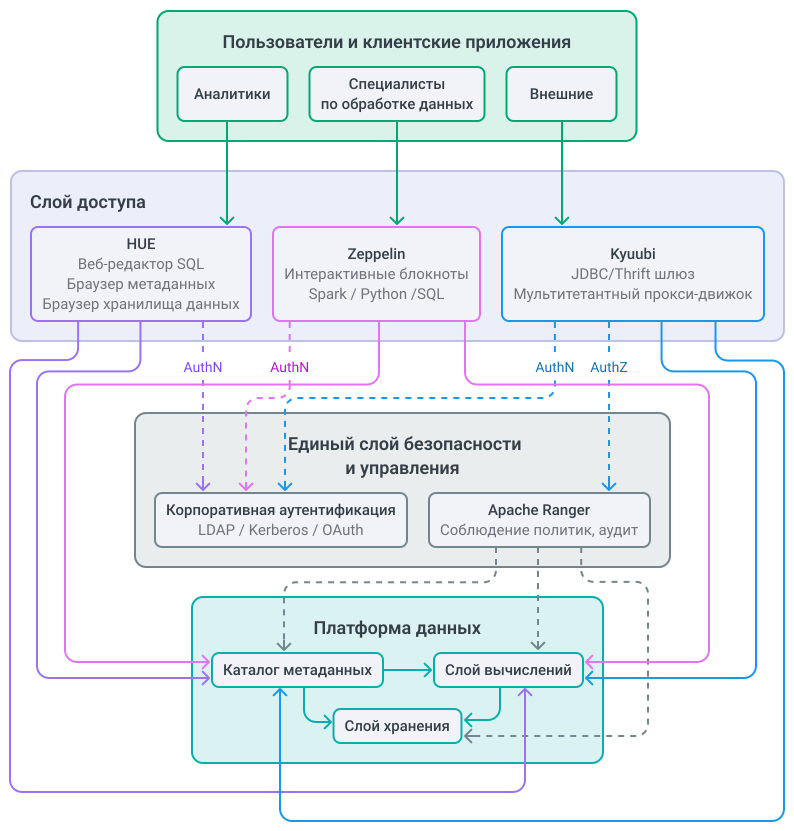
Политики безопасности и управления данными применяются единообразно на всех слоях платформы.
Слой хранения
ADH позволяет как использовать определенную систему хранения, так и объединять несколько сервисов хранения в рамках одного развертывания. Слой хранения — это основа, независимая от формата: он не навязывает одну модель хранения данных, а предоставляет единый логический слой данных, в котором одновременно могут существовать несколько физических хранилищ.
Это обеспечивает федерацию хранения данных, позволяет размещать горячие, теплые и холодные данные на различных носителях и в разных расположениях так, что они будут доступны через те же SQL и вычислительные движки.
| Хранилище | Сценарий использования | Ключевые характеристики |
|---|---|---|
HDFS |
Крупные файлы, интенсивная пакетная обработка, важна локальность данных |
Проверенная локальная система хранения; поддерживает механизм erasure coding для снижения расходов на репликацию |
Ozone |
Большое количество небольших файлов, объектный доступ, совместимость с S3 |
Альтернатива HDFS для объектно-ориентированных нагрузок; поддерживает несколько протоколов доступа (S3, OFS, Ozone FS) |
Внешнее S3-хранилище |
Гибридное облако, обмен данными, резервное копирование, аварийное восстановление |
Данные можно хранить вне кластера ADH; подходит для архивного хранения и межрегиональной репликации |
Слой вычислений
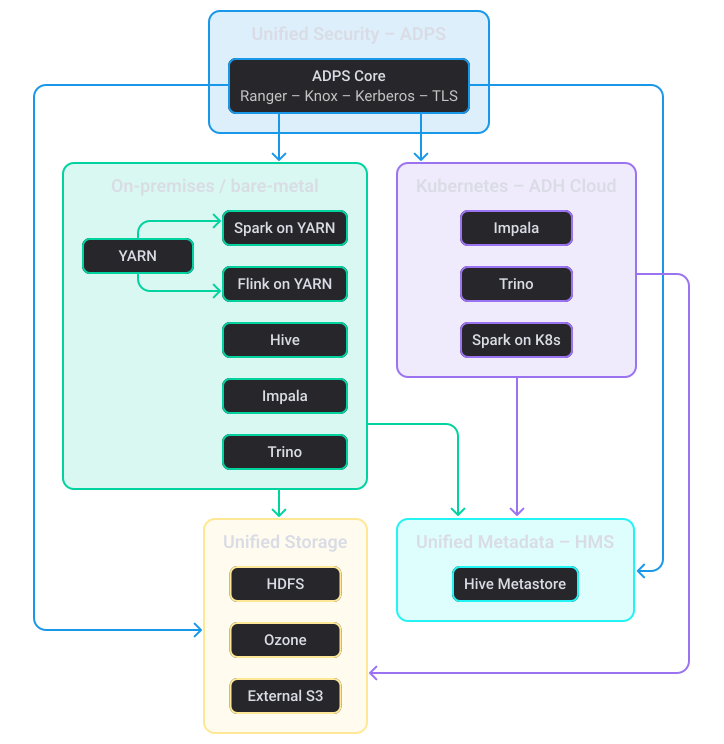
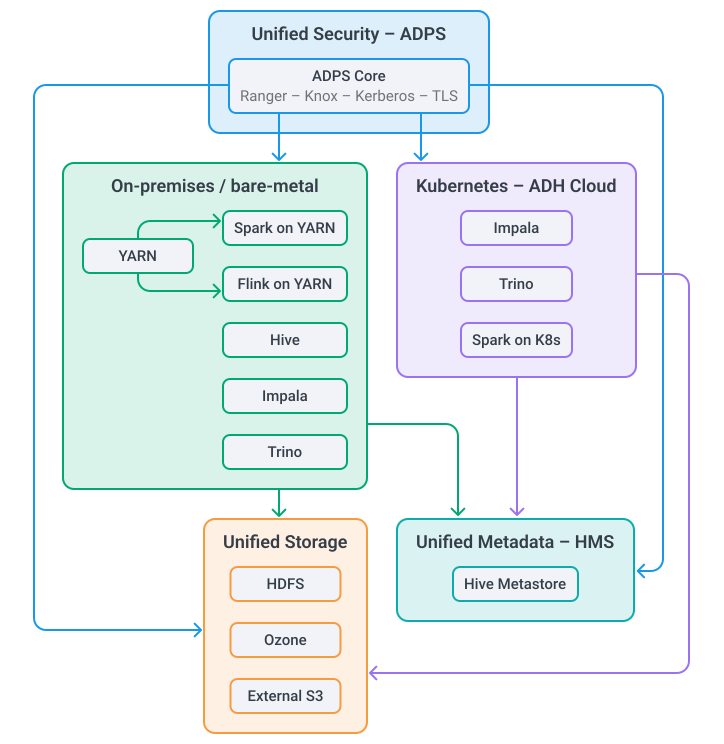
Слой вычислений Arenadata Hyperwave представляет собой гибкую среду выполнения, которая позволяет использовать несколько вычислительных движков и отделяет логику обработки данных от физической инфраструктуры. Вместо привязки рабочих нагрузок к одному движку или модели развертывания платформа предоставляет единый слой вычислений, в котором несколько вычислительных фреймворков могут одновременно работать с одними и теми же наборами данных.
| Функциональность | Описание |
|---|---|
Одновременная работа нескольких движков |
Impala, Spark, Trino, Flink и другие движки могут работать с общими наборами данных через единый слой хранения. Это позволяет устранить изолированные хранилища данных и сократить дублирование ETL-процессов. Одни и те же файлы Parquet или таблицы Iceberg можно использовать для интерактивных запросов, пакетной обработки или потоковой обработки без преобразования форматов и физического копирования данных |
Разделение вычислений и хранения |
Вычислительные кластеры могут работать в локальной инфраструктуре, Kubernetes или публичных облачных средах, в то время как данные хранятся в HDFS, Ozone или S3-совместимых хранилищах. Это позволяет независимо масштабировать вычислительные ресурсы и ресурсы хранения. Например, временные кластеры Spark можно создавать для обработки пиковых нагрузок без увеличения емкости хранения |
Гибридное развертывание |
Платформа поддерживает как традиционные кластеры, развернутые на физических серверах или в виртуальных машинах (на базе YARN или bare metal), так и облачно-ориентированную оркестрацию Kubernetes. Сервисы, чувствительные к задержкам, такие как Impala, могут работать на выделенных физических узлах, тогда как нагрузки Spark можно развертывать в Kubernetes для использования преимуществ контейнеризации и эластичного масштабирования |
Единое управление и безопасность |
Инструменты ADPS позволяют применять механизмы управления доступом, маскирования данных и аудита единообразно независимо от используемого движка выполнения или среды развертывания. Политики Apache Ranger, аутентификация Kerberos и шифрование данных при передаче одинаково работают как в автономных, так и в Kubernetes-ориентированных средах выполнения |
Слой доступа
Слой доступа предоставляет единую точку взаимодействия для всех пользователей платформы. Вместо прямого доступа к вычислительным сервисам он позволяет использовать безопасные и удобные интерфейсы, скрывающие сложность вычислительных движков и позволяющие аналитикам, специалистам по работе с данными и разработчикам приложений работать с одними и теми же данными с помощью инструментов, соответствующих их задачам.
| Функциональность | Описание |
|---|---|
Интерактивные SQL-запросы и исследование данных |
Apache HUE предоставляет веб-интерфейс, в котором аналитики имеют возможность выполнять запросы к Impala, Spark SQL, Hive и Trino, просматривать схемы таблиц и управлять заданиями через единый веб-интерфейс |
Корпоративный JDBC/Thrift-шлюз |
Apache Kyuubi предоставляет многопользовательский высокопроизводительный шлюз для доступа к Spark и другим движкам через стандартные интерфейсы JDBC и Thrift. BI-инструменты, платформы отчетности и пользовательские приложения подключаются через Kyuubi, а не напрямую к узлам кластера, что обеспечивает изоляцию сессий, справедливое распределение ресурсов и прозрачную маршрутизацию запросов к движкам |
Многопользовательские блокноты для анализа данных |
Apache Zeppelin предоставляет интерактивные многоязычные блокноты со встроенными интерпретаторами для Spark, SQL, Python и R. Специалисты по работе с данными могут создавать прототипы конвейеров обработки данных, визуализировать результаты и совместно использовать интерактивные блокноты, работать с теми же таблицами Iceberg и наборами данных Parquet, что и пользователи SQL |
Единая аутентификация и авторизация |
Каждая точка входа, включая сессии Hue, JDBC-подключения через Kyuubi и блокноты Zeppelin, интегрируется с корпоративными системами управления идентификацией, такими как LDAP, Kerberos, SAML и OAuth. Apache Ranger позволяет применять политики авторизации централизованно, использовать построчную фильтрацию данных, маскирование столбцов и ведение журналов аудита |