

Метрики мониторинга ADO
В этой статье описаны метрики для мониторинга кластера ADO. Информацию о мониторинге, его компонентах и установке можно прочитать в статье Установка мониторинга.
Обзор
Сервис Monitoring собирает метрики компонентов ADO и делает их доступными через VictoriaMetrics и Grafana. VMAgent собирает метрики с настроенных экспортеров и сервисов ADO и отправляет их в кластер VictoriaMetrics. Мониторинг на основе Prometheus также можно использовать в качестве альтернативы и совместно с мониторингом на основе VictoriaMetrics. Grafana визуализирует собранные метрики на дашбордах.
Эти инструменты помогают отслеживать состояние кластера ADO, контролировать синхронизацию GitSync, наблюдать за активностью Airflow, отслеживать работу рабочих процессов Celery и анализировать использование ресурсов хоста.
Сервис Monitoring состоит из следующих компонентов:
-
Node Exporter — предоставляет метрики оборудования и операционной системы, такие как использование CPU, памяти, диска и сети. Эти метрики доступны на порту и эндпоинте, указанных в разделе Node Exporter settings конфигурации сервиса Monitoring (
11203/metricsпо умолчанию). -
VMAgent — собирает метрики с настроенных экспортеров и сервисов ADO и отправляет их в кластер VictoriaMetrics.
-
Prometheus Server — предоставляет альтернативное решение для сбора и хранения метрик на основе Prometheus. Может использоваться совместно с мониторингом на основе VictoriaMetrics.
-
Grafana — визуализирует собранные метрики на дашбордах. Grafana может использовать VictoriaMetrics или Prometheus в качестве источника данных.
Просмотр метрик в Prometheus
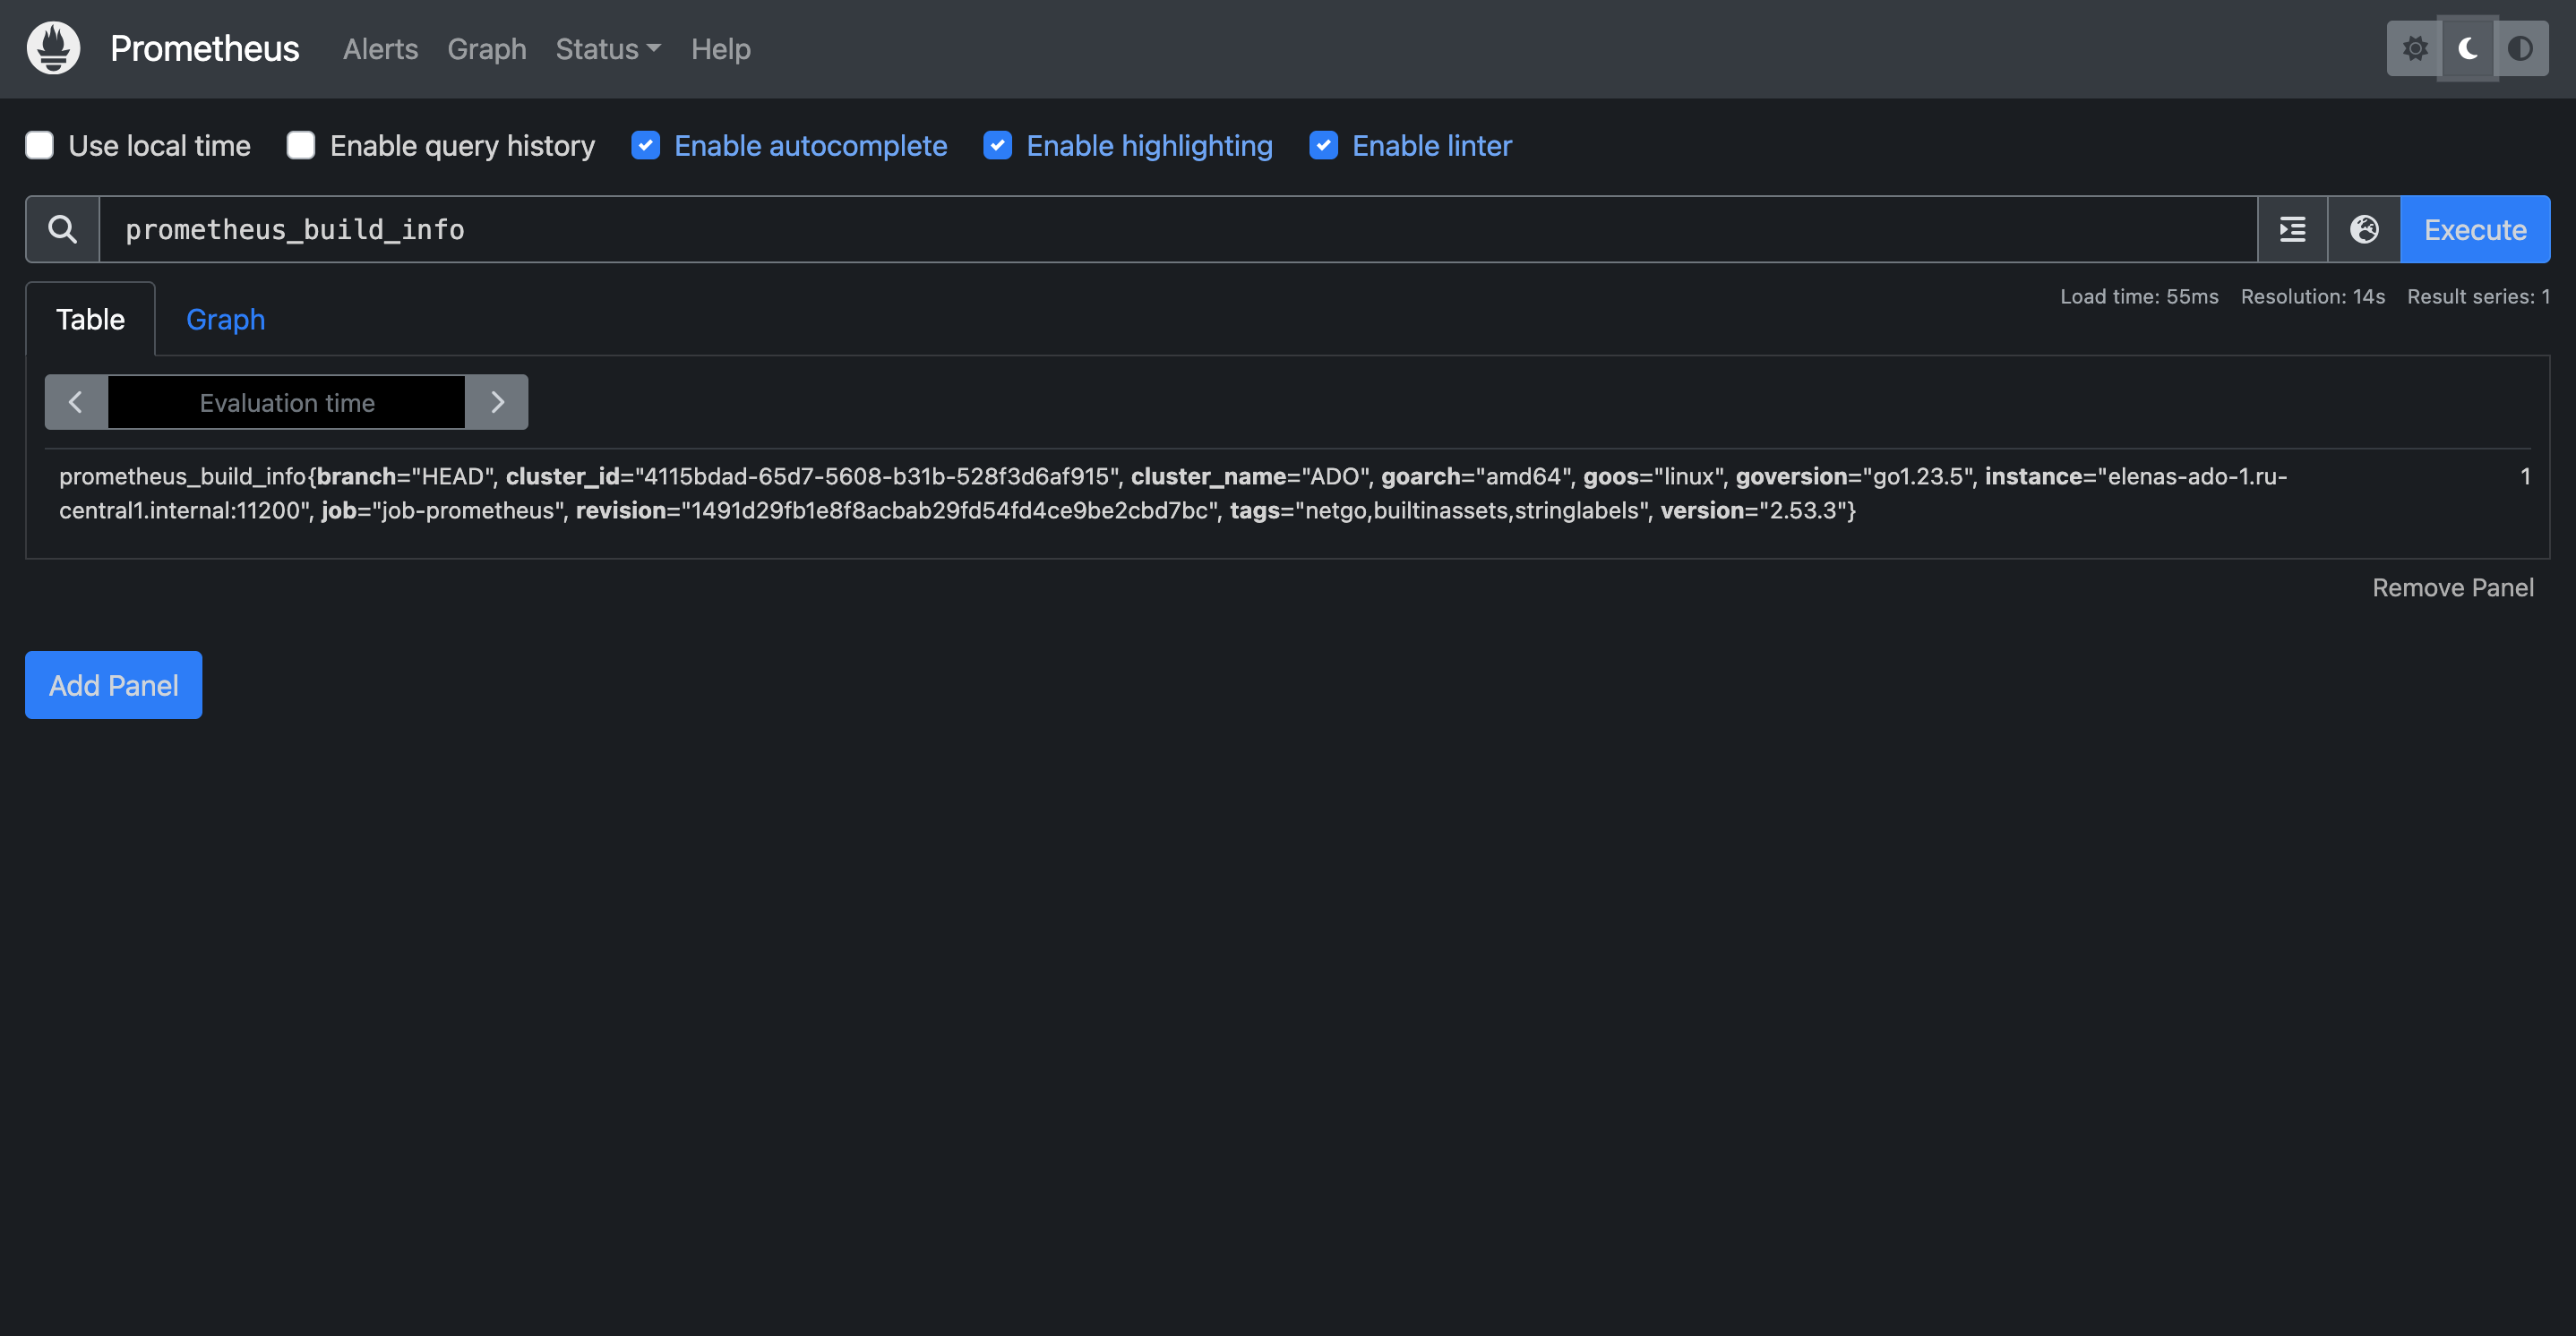
Prometheus — это набор инструментов для мониторинга и оповещения. Он собирает метрики кластера ADO и его сервисов, а Grafana получает эти метрики из Prometheus для построения дашбордов. Если на дашборде Grafana отображаются пустые панели или неожиданные значения, проверка Prometheus помогает определить, связана ли проблема со сбором метрик или с конфигурацией дашборда.
Чтобы просмотреть метрики в Prometheus:
-
В браузере введите
<IP-адрес сервера мониторинга>:<порт>. Порт11200используется по умолчанию. Его можно изменить в разделе Prometheus settings конфигурации сервиса Monitoring.IP-адрес, порт и имя хоста Prometheus также доступны на вкладке Info сервиса Monitoring.
-
В открывшемся окне введите имя пользователя и пароль, настроенные в поле Prometheus users to login/logout to Prometheus конфигурации сервиса Monitoring.
В веб-интерфейсе Prometheus можно:
-
просматривать конфигурацию Prometheus;
-
проверять доступность экспортеров и сервисов ADO на странице Targets;
-
выполнять запросы к собранным метрикам с помощью языка запросов Prometheus (PromQL).
Дашборды Grafana
Grafana визуализирует метрики, собранные системой мониторинга, и организует их в дашборды. В зависимости от настроенного решения для мониторинга Grafana может использовать VictoriaMetrics или Prometheus в качестве источника данных. Предоставленные дашборды можно использовать для мониторинга сервисов ADO или создавать собственные дашборды на основе собранных метрик.
Чтобы открыть Grafana:
-
В браузере введите
<IP-адрес сервера мониторинга>:<порт>. Порт11210используется по умолчанию. Его можно изменить в разделе Grafana settings конфигурации сервиса Monitoring.IP-адрес, порт и имя хоста Grafana также доступны на вкладке Info сервиса Monitoring.
-
В открывшемся окне в поле Email or username введите
admin, а в поле Password — пароль, настроенный в поле Grafana administrator’s password конфигурации сервиса Monitoring.
По умолчанию в Grafana доступны следующие дашборды:
Каждый дашборд предназначен для мониторинга определенного компонента ADO и предоставляет относящиеся к его работе метрики.
В следующих разделах описаны доступные дашборды и предоставляемые ими метрики.
GitSync Monitoring
Дашборд GitSync Monitoring предоставляет информацию о синхронизации репозиториев, операциях Git, проверках, доступности воркеров и установке зависимостей.
Этот дашборд помогает выявлять ошибки синхронизации, отслеживать производительность синхронизации, обнаруживать проблемы при проверке репозиториев и проверять корректность работы воркеров GitSync.
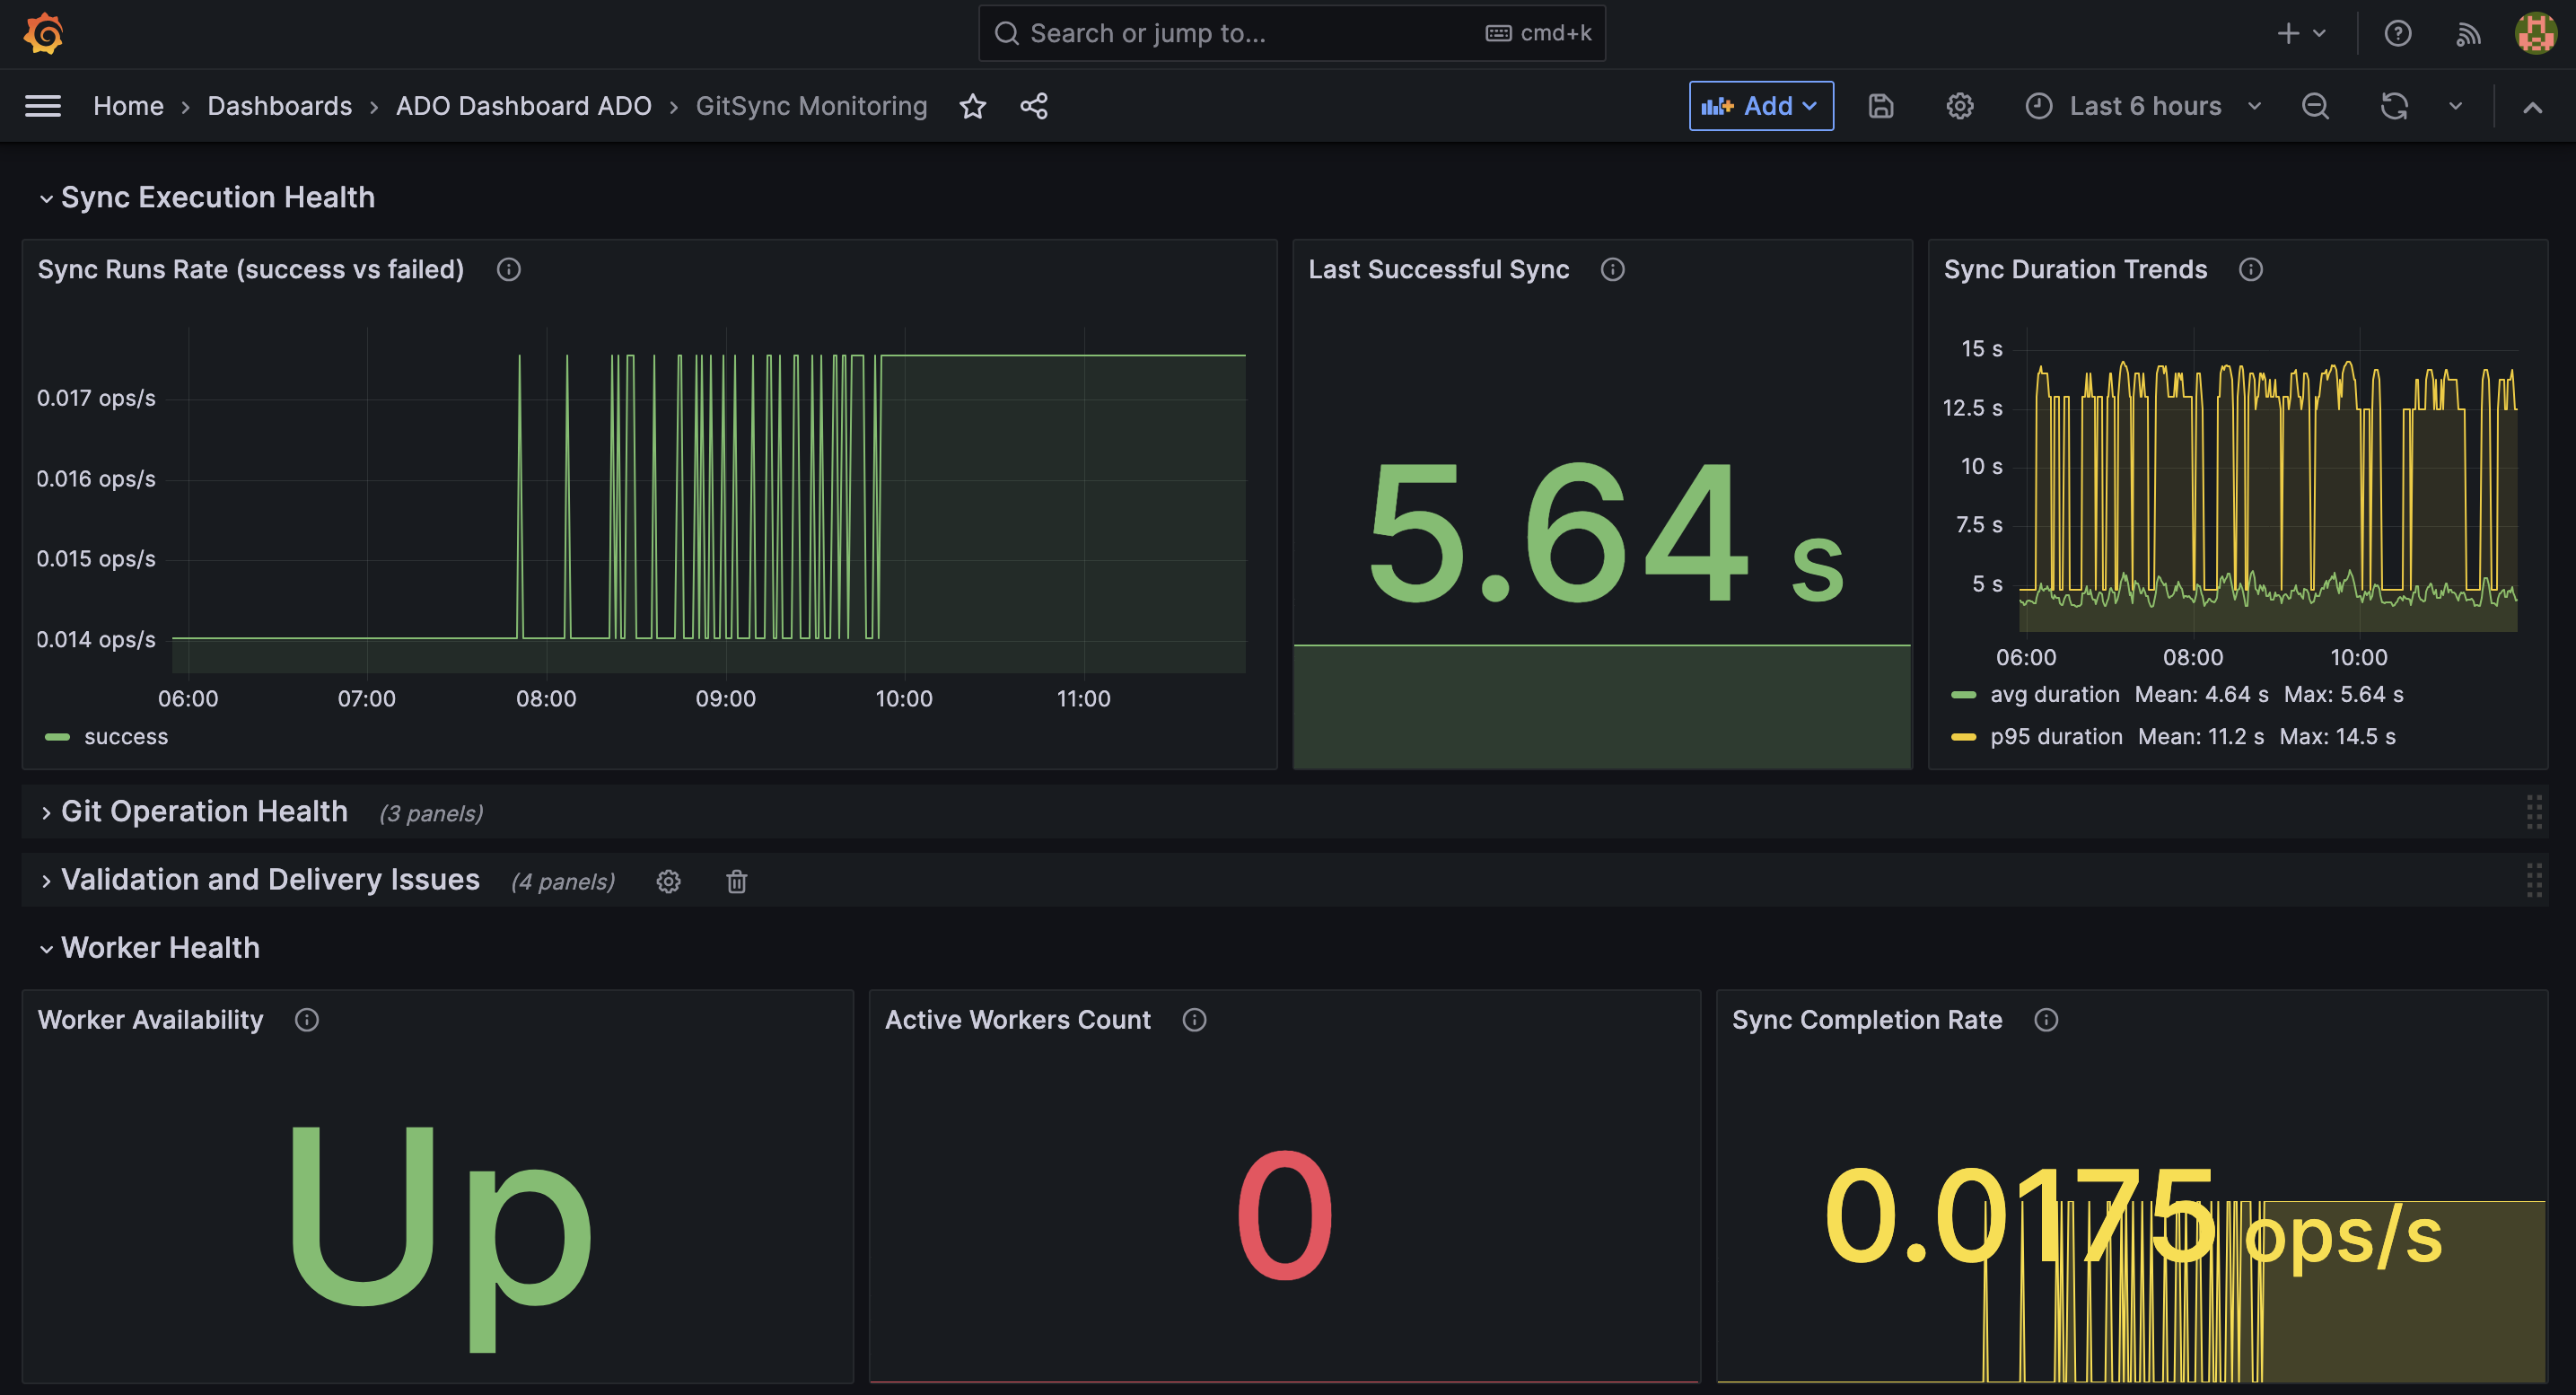
В таблице ниже перечислены доступные графики.
| Название графика | Описание |
|---|---|
Sync Runs Rate (success vs failed) |
Показывает скорость выполнения успешных и неуспешных операций синхронизации репозиториев во времени |
Last Successful Sync |
Отображает длительность последней успешной синхронизации |
Sync Duration Trends |
Показывает длительность синхронизации во времени, включая среднюю длительность и 95-й процентиль (p95). Эта панель помогает выявлять снижение производительности и необычно длительные операции синхронизации |
Git Operations Volume |
Показывает количество выполненных операций Git во времени |
Git Operation Latency (avg and p95) |
Отображает среднюю длительность операций Git и длительность, соответствующую 95-му процентилю |
Failed Git Operations |
Показывает количество неудачных операций Git |
Validation Errors |
Отображает количество ошибок проверки репозитория, обнаруженных во время синхронизации |
Target Directory Writability |
Показывает, доступна ли целевая директория синхронизации для записи |
Files Synced Rate |
Показывает скорость синхронизации файлов |
Total Files Synced (30m) |
Отображает общее количество файлов, синхронизированных за последние 30 минут |
Worker Availability |
Показывает, доступен ли воркер GitSync для обработки запросов на синхронизацию |
Active Workers Count |
Отображает количество активных воркеров GitSync |
Sync Completion Rate |
Показывает скорость завершения операций синхронизации |
Pip Install Duration |
Отображает длительность установки зависимостей из файла requirements.txt во время синхронизации репозитория |
Airflow cluster dashboard
Дашборд Airflow cluster dashboard предоставляет обзор состояния и производительности компонентов Airflow. Он включает метрики планировщика, статистику исполнителя, метрики выполнения задач и показатели производительности выполнения DAG.
Этот дашборд помогает проверять корректность работы компонентов Airflow, обнаруживать проблемы с планировщиком, отслеживать выполнение задач и выявлять узкие места, влияющие на работу сервиса.
На странице доступен фильтр Airflow Instance Id, позволяющий отображать метрики для определенного хоста.
В таблице ниже перечислены доступные графики.
| Название графика | Описание |
|---|---|
Scheduler heartbeat |
Показывает, что планировщик работает и периодически обновляет heartbeat. Отсутствие изменений может указывать на некорректную работу планировщика |
Dagbag size |
Отображает количество DAG, загруженных DAG Processor в данный момент |
DAG processing total parse time |
Показывает общее время, необходимое DAG Processor для парсинга всех DAG-файлов |
Dagbag import errors |
Отображает количество ошибок, возникших при импорте DAG |
Zombies killed |
Показывает количество обнаруженных и завершенных планировщиком задач, находящихся в состоянии |
Total successful tasks |
Отображает суммарное количество успешно завершенных задач |
Operator success rate per minute |
Показывает скорость выполнения успешно завершенных задач с разбивкой по типу оператора |
Operator failure rate per minute |
Показывает скорость выполнения неуспешных задач с разбивкой по типу оператора |
Total failed tasks |
Отображает суммарное количество неуспешных выполнений задач |
Jobs started per minute |
Показывает скорость запуска задач |
Executor running tasks |
Отображает количество задач, выполняющихся в данный момент |
Executor queued tasks |
Показывает количество задач, ожидающих выполнения |
Jobs ended per minute |
Отображает скорость завершения задач |
Executor open slots |
Показывает количество слотов исполнителя, доступных в данный момент для выполнения задач |
Success DAG run duration |
Отображает длительность выполнения успешных запусков DAG. Процентили (p50, p90 и p99) помогают определить типичную длительность и длительность медленных рабочих процессов |
Failed DAG run duration |
Показывает длительность выполнения неуспешных запусков DAG |
DAG run duration |
Отображает длительность выполнения всех запусков DAG независимо от их статуса |
DAG run dependency check time |
Показывает время, необходимое для проверки зависимостей задач перед началом запуска DAG |
DAG run schedule delay |
Отображает задержку между запланированным временем запуска и фактическим началом запуска DAG |
Airflow DAG dashboard
Дашборд Airflow DAG dashboard предназначен для мониторинга показателей производительности отдельного DAG. Он помогает анализировать время выполнения рабочего процесса, задержки планирования и разрешение зависимостей для выбранного рабочего процесса.
Этот дашборд полезен для анализа поведения отдельных рабочих процессов, выявления задержек планирования и обнаружения снижения производительности определенных DAG.
Используйте фильтр DAG ID в верхней части дашборда, чтобы выбрать DAG, метрики которого необходимо отслеживать.
В таблице ниже перечислены доступные графики.
| Название графика | Описание |
|---|---|
Success DAG run duration |
Отображает длительность выполнения успешных запусков выбранного DAG |
Failed DAG run duration |
Показывает длительность выполнения неуспешных запусков выбранного DAG |
DAG run duration |
Отображает длительность выполнения всех запусков выбранного DAG независимо от их статуса |
DAG run dependency check time |
Показывает время, необходимое для проверки зависимостей перед началом каждого запуска DAG |
DAG run schedule delay |
Отображает задержку между запланированным временем запуска и фактическим началом каждого запуска DAG |
Celery Monitoring
Дашборд Celery Monitoring предоставляет информацию о состоянии воркеров Celery и корректности выполнения ими задач.
В таблице ниже перечислены доступные графики.
| Название графика | Описание |
|---|---|
Celery Worker Status |
Показывает, доступны ли воркеры Celery в данный момент и отвечают ли они на запросы |
Number of Tasks Currently Executing at Worker |
Отображает количество задач, выполняемых в данный момент каждым воркером Celery |
Node Exporter Full
Этот дашборд предоставляет метрики операционной системы и оборудования, собранные с хостов, на которых работают компоненты ADO.
Он помогает отслеживать использование CPU, памяти, хранилища, сети и системных ресурсов, диагностировать проблемы с производительностью.
В верхней части дашборда доступны следующие фильтры:
-
Datasource — настроенный источник данных VictoriaMetrics или Prometheus.
-
Job — задание для сбора метрик.
-
Host — хост, метрики которого необходимо отобразить.
Дашборд содержит следующие разделы.
| Секция | Описание |
|---|---|
Quick CPU / Mem / Disk |
Предоставляет общий обзор использования CPU, системной нагрузки, памяти, swap, файловой системы, времени работы системы и доступных аппаратных ресурсов |
Basic CPU / Mem / Net / Disk |
Отображает основные метрики CPU, памяти, сети и файловой системы для выбранного хоста |
Memory Meminfo |
Предоставляет подробную информацию об использовании физической памяти, полученную от операционной системы |
Memory Vmstat |
Отображает статистику виртуальной памяти, включая активность подкачки и управления памятью |
System Timesync |
Показывает метрики синхронизации времени, которые помогают проверить синхронизацию часов на отслеживаемом хосте |
System Processes |
Предоставляет статистику выполняющихся процессов и их состояний |
System Misc |
Отображает различные метрики операционной системы, включая файловые дескрипторы, прерывания, переключения контекста и другую статистику ядра |
Hardware Misc |
Предоставляет метрики оборудования, собранные операционной системой |
Systemd |
Отображает метрики сервисов, управляемых systemd |
Storage Disk |
Предоставляет подробную статистику операций ввода-вывода дисков и метрики производительности устройств хранения данных |
Storage Filesystem |
Отображает емкость файловых систем, степень их использования и доступное пространство |
Network Traffic |
Показывает входящий и исходящий сетевой трафик для каждого сетевого интерфейса |
Network Sockstat |
Отображает статистику использования сокетов |
Network Netstat |
Предоставляет статистику сетевых протоколов, полученную от операционной системы |
Node Exporter |
Отображает внутренние метрики, предоставляемые процессом Node Exporter |