

Расширение для работы с HDFS/Ozone/Hive Metastore
ADO предоставляет расширение DuckDB, которое обеспечивает доступ к распределенным файловым системам и каталогам таблиц. Расширение поддерживает чтение и запись данных в HDFS и Apache Ozone, выполнение запросов к таблицам, зарегистрированным в Hive Metastore, а также работу с поддерживаемыми таблицами в форматах Parquet, CSV, Apache Iceberg и Apache Paimon.
Расширение поставляется вместе с сервисом DuckDB и управляется через ADCM. Устанавливать его отдельно не требуется.
Расширение предоставляет следующие возможности:
-
Чтение и запись файлов в HDFS с использованием схемы
hdfs://. -
Чтение и запись файлов в Ozone с использованием схем
ofs://иo3fs://. -
Просмотр списка файлов и директорий, использование шаблонов glob, просмотр схем Parquet и выполнение файловых операций.
-
Доступ к защищенным кластерам Hadoop с использованием Kerberos и файлов конфигурации Hadoop.
-
Подключение каталогов Hive Metastore и выполнение запросов к зарегистрированным таблицам.
-
Чтение и запись данных в поддерживаемых форматах таблиц через Hive Metastore.
-
Повторное использование подключений к файловой системе и Metastore, а также восстановление после сбоев.
Включение и отключение расширения
По умолчанию расширение отключено. Чтобы включить или отключить его через ADCM, выполните следующие действия:
-
На странице Clusters выберите нужный кластер.
-
Откройте вкладку Services и выберите DuckDB.
-
В разделе конфигурации ADO extensions включите или отключите расширение HDFS/Ozone/Hive Metastore с помощью соответствующего переключателя. При необходимости настройте параметры.
-
Нажмите Save.
-
В выпадающем меню Actions выберите Restart. Убедитесь, что параметру Apply configs from ADCM присвоено значение
true, и нажмите Run.
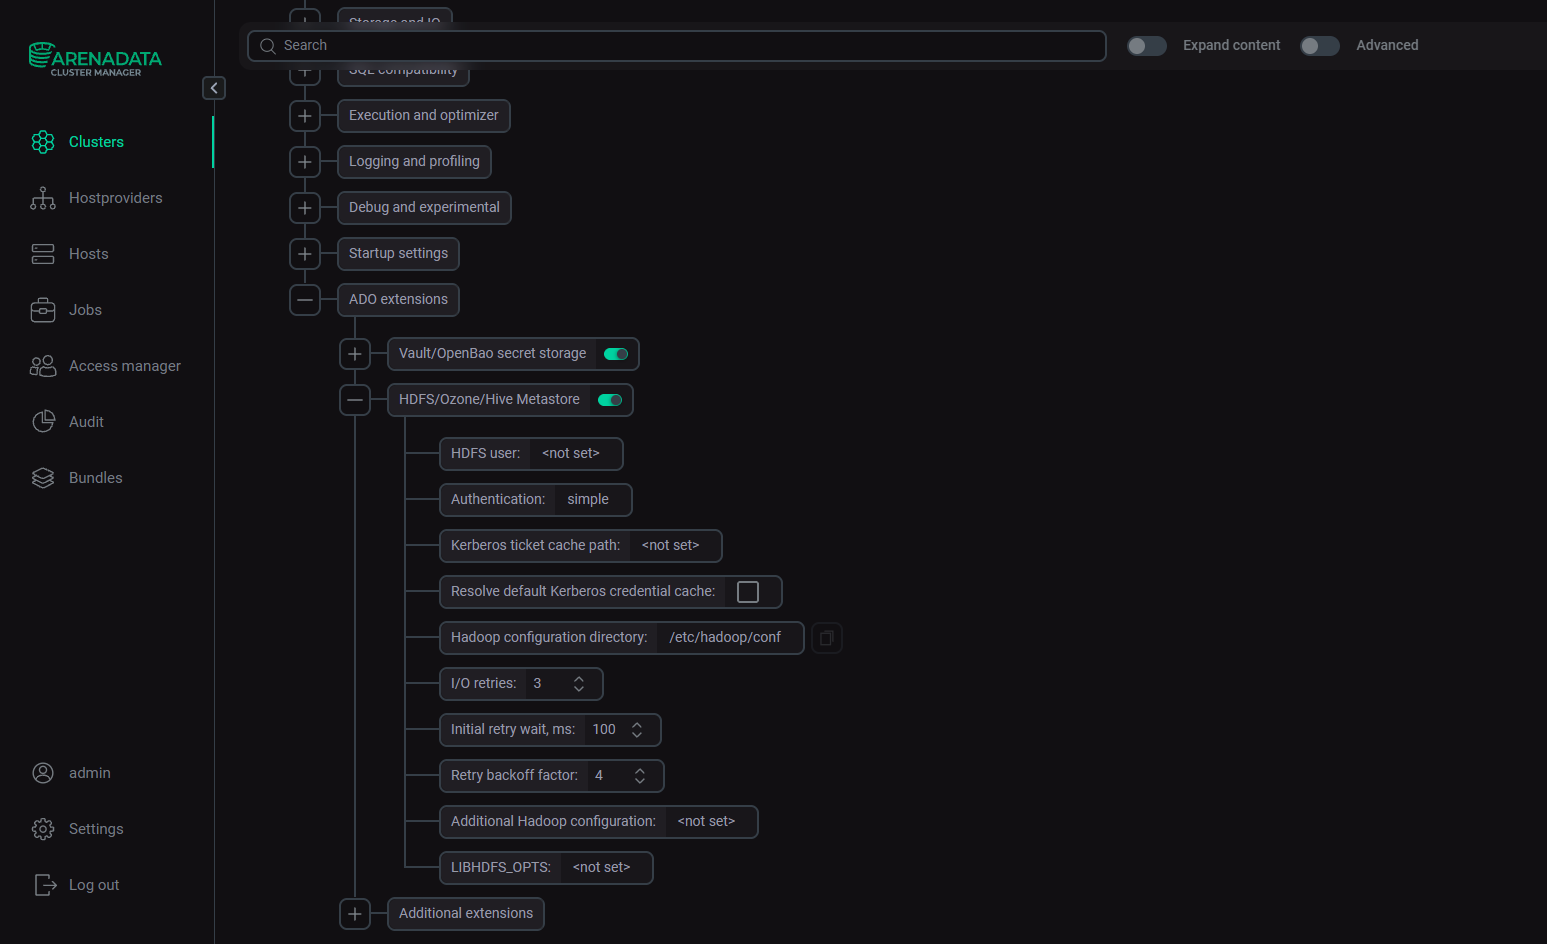
После перезапуска сервиса DuckDB использует обновленную конфигурацию.
ADCM управляет расширением на уровне сервиса. Параметры подключения к файловой системе, параметры аутентификации и настройки каталога также можно задавать с помощью SQL-инструкций DuckDB или кода DAG в зависимости от сценария использования. Эти настройки не заменяют конфигурацию на уровне сервиса.
Конфигурация
Расширение можно настраивать на нескольких уровнях:
-
ADCM включает и отключает расширение, а также настраивает общую среду выполнения. Доступные параметры конфигурации DuckDB описаны в разделе Параметры конфигурации DuckDB.
-
Настройки DuckDB SQL определяют доступ к файловой системе и поведение среды выполнения для текущего процесса DuckDB.
-
Секреты DuckDB хранят параметры подключения к определенной файловой системе или кластеру, включая имя пользователя, метод аутентификации, путь к кешу тикетов Kerberos и конфигурацию Hadoop.
-
Параметры подключения каталога настраивают доступ к каталогу Hive Metastore, включая конечную точку Metastore, расположение хранилища и специфичные для Metastore свойства.
Настройки ADCM применяются при запуске сервиса. Настройки SQL и секреты задаются с помощью SQL-инструкций или кода DAG. Параметры каталога указываются при его подключении.
Минимальная конфигурация
Для незащищенного кластера HDFS включите расширение и укажите конечную точку HDFS в URL файла:
LOAD hdfs;

SELECT *
FROM read_parquet('hdfs://<namenode.example.com:8020>/warehouse/events/*.parquet')
LIMIT 10;
где namenode.example.com:8020 — хост и порт NameNode. Для кластера с высокой доступностью (HA) вместо адреса отдельного NameNode можно использовать настроенное имя службы (nameservice).
Для защищенного кластера настройте необходимые параметры аутентификации и укажите файлы конфигурации Hadoop.
Конфигурация Hadoop
Расширение использует файлы конфигурации Hadoop core-site.xml и hdfs-site.xml. Для доступа к Ozone также может потребоваться файл ozone-site.xml. Для интеграции с Hive Metastore могут потребоваться файлы hive-site.xml и metastore-site.xml.
Укажите директорию, содержащую эти файлы, через ADCM в параметре конфигурации Hadoop configuration directory либо с помощью hdfs_config_dir или переменной окружения HADOOP_CONF_DIR:
SET hdfs_config_dir = '/etc/hadoop/conf';Директория должна содержать конфигурацию, необходимую для подключения к целевому кластеру.
Расширение включает клиентские библиотеки Hadoop, среду выполнения Java и необходимые библиотеки файловых систем. Сервис DuckDB настраивает среду выполнения для этих компонентов. Отдельная установка Hadoop и ручная настройка пути к классам Java обычно не требуются.
Чтобы передать дополнительные свойства Hadoop, используйте параметр Additional Hadoop configuration в ADCM. В качестве альтернативы можно передать hdfs_conf или свойство conf секрета HDFS. Укажите свойства в виде пар key=value, разделенных точками с запятой.
SET hdfs_conf = 'dfs.client.read.shortcircuit=true;dfs.domain.socket.path=/var/run/hdfs/dn._PORT';В этом примере на стороне клиента включается чтение в обход сетевого стека (short-circuit reads). На DataNode также должно быть включено чтение в обход сетевого стека, а процесс DuckDB должен иметь доступ на уровне операционной системы к настроенному доменному сокету. Путь к сокету должен соответствовать конфигурации DataNode.
Встроенная JVM инициализируется один раз для каждого процесса DuckDB. Настройте Hadoop до выполнения первого запроса, использующего соответствующую файловую систему. Последующее изменение конфигурации не приводит к повторной инициализации JVM.
Аутентификация Kerberos
Расширение поддерживает настройки аутентификации Hadoop, включая Kerberos. Данные для аутентификации можно передавать через ADCM, настройки SQL или секрет HDFS.
Для аутентификации Kerberos расширение использует существующий кеш учетных данных Kerberos. Прямая аутентификация с использованием keytab не поддерживается.
Перед выполнением запросов к кластеру получите тикет Kerberos:
$ kinitНастройте метод аутентификации и путь к кешу тикетов:
SET hdfs_authentication = 'kerberos';
SET hdfs_kerberos_ticket_cache_path = '/tmp/krb5cc_1000';
SET hdfs_config_dir = '/etc/hadoop/conf';
Чтобы настроить дефолтные значения через ADCM, выполните следующие действия:
-
На странице Clusters выберите нужный кластер.
-
Откройте вкладку Services и выберите DuckDB.
-
В разделе конфигурации ADO extensions разверните раздел расширения HDFS/Ozone/Hive Metastore и заполните следующие поля:
-
HDFS user
-
Authentication
-
Kerberos ticket cache path
-
-
Нажмите Save.
-
В выпадающем меню Actions выберите Restart. Убедитесь, что параметру Apply configs from ADCM присвоено значение
true, и нажмите Run.
Во время выполнения запросов кеш тикетов должен оставаться действительным. Для длительных рабочих процессов предусмотрите внешнее обновление учетных данных, например с помощью запланированного процесса.
Если подключение из пула завершается с ошибкой из-за отсутствующего или просроченного тикета Kerberos, расширение может закрыть подключение и один раз подключиться повторно, перечитав кеш тикетов. Этот механизм восстановления применяется при аутентификации через кеш тикетов. Он не выполняет вход с использованием keytab внутри процесса.
Если параметры подключения к нескольким кластерам различаются, используйте отдельный секрет для каждого кластера. DuckDB определяет данные для аутентификации в следующем порядке:
-
Подходящий секрет HDFS, область действия которого соответствует URL.
-
Явно заданная настройка SQL.
-
Значение по умолчанию.
Следующий пример SQL-запроса создает в DuckDB именованный секрет HDFS для аутентификации Kerberos:
CREATE SECRET prod_hdfs (
    TYPE hdfs,
    SCOPE 'hdfs://nameservice1',
    user 'analytics',
    authentication 'kerberos',
    kerberos_ticket_cache_path '/tmp/krb5cc_1000'
);
Секрет применяется к URL, соответствующим указанной области действия. Для каждого кластера используйте подходящую область действия.
Повторные попытки подключения и восстановление
Расширение объединяет подключения к файловой системе в пул по следующим параметрам: authority, пользователь, метод аутентификации, кеш тикетов и конфигурация Hadoop. Повторное использование подключений снижает накладные расходы при выполнении повторяющихся операций.
Для некоторых операций чтения предусмотрено восстановление после временных сбоев. К таким операциям относятся подключение, проверка метаданных файлов, просмотр списка директорий, обработка шаблонов glob, открытие файлов и чтение данных.
Настройте поведение повторных попыток через ADCM или с помощью настроек SQL:
SET hdfs_retries = 3;
SET hdfs_retry_wait_ms = 100;
SET hdfs_retry_backoff = 4.0;
Параметр hdfs_retries задает количество повторных попыток после временных ошибок ввода-вывода. Чтобы отключить повторные попытки, установите значение 0. Параметр hdfs_retry_wait_ms задает начальную задержку между повторными попытками в миллисекундах, а hdfs_retry_backoff — множитель, применяемый после каждой повторной попытки.
Расширение повторяет попытки при некоторых временных ошибках, таких как временный отказ в подключении, тайм-аут сокета и прерывание соединения при переключении NameNode. Изменяющие операции, включая создание, удаление, переименование и запись файлов, автоматически не повторяются.
Чтобы очистить пул подключений к файловой системе после внешнего обновления тикета Kerberos, изменения конфигурации или проблем с подключением, выполните следующий запрос:
SELECT success
FROM clear_hdfs_connection_cache();
Эта функция очищает кешированные подключения без перезапуска DuckDB или JVM. Она не выполняет повторную инициализацию JVM и не перезагружает ее стартовую конфигурацию.
Переменные окружения и память
Встроенная JVM работает внутри процесса DuckDB. Потребление памяти JVM учитывается отдельно от памяти, используемой для выполнения запросов DuckDB и внешнего кеша файлов.
Память встроенной JVM
Размер кучи JVM можно ограничить с помощью переменной окружения LIBHDFS_OPTS. Задайте эту переменную до выполнения первого запроса к HDFS или Ozone, поскольку JVM инициализируется один раз для каждого процесса.
$ export LIBHDFS_OPTS="-Xmx1g"В этом примере размер кучи JVM ограничивается 1 ГБ. Выберите подходящее значение с учетом рабочей нагрузки и доступного объема памяти хоста.
Память DuckDB и внешний кеш файлов
Лимит памяти DuckDB можно настроить отдельно от размера кучи JVM:
SET memory_limit = '8GB';
SET enable_external_file_cache = false;
Параметр memory_limit ограничивает объем памяти, доступной DuckDB, включая память для операторов выполнения запросов и соответствующих буферов. DuckDB также использует внешний кеш файлов для хранения в памяти диапазонов данных удаленных файлов.
Установка enable_external_file_cache в значение false отключает этот кеш. Это может снизить потребление памяти при повторном сканировании, но увеличить количество операций ввода-вывода, поскольку данные придется повторно считывать из источника.
Эти настройки памяти DuckDB не относятся исключительно к HDFS: они также влияют на другие поддерживаемые файловые системы.
Доступ к Ozone
Расширение поддерживает Apache Ozone с использованием схем файловой системы ofs:// и o3fs://. Встроенный клиент файловой системы Ozone позволяет встроенной JVM обрабатывать эти схемы без отдельной установки клиента Ozone.
Рекомендуется использовать схему ofs://. В поле authority URL указывается хост и порт Ozone Manager либо настроенный идентификатор службы HA. Путь содержит том, бакет и ключ объекта.
Например:
SELECT count(*)
FROM 'ofs://om.example.com:9862/vol1/warehouse/events/*.parquet';
В Ozone используются те же настройки аутентификации и конфигурация подключений, что и в HDFS. Задайте hdfs_config_dir или HADOOP_CONF_DIR, указав директорию с необходимыми файлами конфигурации Hadoop и Ozone, включая ozone-site.xml.
Настройте конфигурацию до выполнения первого запроса к Ozone, поскольку JVM инициализируется один раз для каждого процесса.
При записи в Ozone целевые том и бакет должны уже существовать. DuckDB записывает ключи объектов, но не создает тома или бакеты. У настроенной учетной записи должны быть необходимые разрешения.
Обратите внимание, что hdfs_read_stats() возвращает статистику потоков, специфичную для HDFS, и для Ozone ее значения остаются равными нулю. Чтобы просмотреть количество байтов и операций на уровне расширения для запросов к Ozone, используйте информацию HDFS Stats, отображаемую командой EXPLAIN ANALYZE.
Интеграция с Hive Metastore
Расширение позволяет подключить каталог Hive Metastore к DuckDB. Каталог получает имена таблиц, схемы, форматы хранения и расположение данных через Metastore. Затем DuckDB считывает или записывает данные в базовой файловой системе с использованием настроенной файловой системы.
В зависимости от конфигурации кластера конечная точка Metastore может представлять собой один Thrift URL, список конечных точек через запятую для HA или кворум ZooKeeper для обнаружения сервисов.
ATTACH 'thrift://hms.example.com:9083' AS hms (
    TYPE hive_metastore,
    WAREHOUSE_LOCATION 'hdfs://nameservice1/warehouse'
);
Параметр WAREHOUSE_LOCATION необязателен. Он задает расположение по умолчанию для таблиц, создаваемых без явно указанного расположения.
Если таблица создается без параметра location и при подключении каталога был указан WAREHOUSE_LOCATION, ее расположение по умолчанию имеет вид <WAREHOUSE_LOCATION>/<database>/<table>. В противном случае расположение определяется на основе расположения базы данных по умолчанию в Hive Metastore.
Клиент Metastore использует ту же встроенную JVM, что и расширение файловой системы. В средах с аутентификацией Kerberos существующий кеш тикетов можно использовать как для доступа к Metastore, так и для доступа к данным.
Дополнительные свойства Hadoop и Metastore можно передать через параметр подключения conf. Укажите свойства в виде пар key=value, разделенных точками с запятой.
ATTACH 'thrift://hms.example.com:9083' AS hms (
    TYPE hive_metastore,
    WAREHOUSE_LOCATION 'hdfs://nameservice1/warehouse',
    conf 'metastore.client.socket.timeout=120s;metastore.failure.retries=5;metastore.client.connect.retry.delay=5s'
);
Эти свойства применяются к конфигурации клиента Metastore до установления подключения. С их помощью можно настроить тайм-ауты сокетов, повторные попытки подключения и другие поддерживаемые параметры Hadoop или Hive.
Для доступа к Metastore с аутентификацией Kerberos соответствующие параметры SASL и Kerberos должны присутствовать в конфигурации Hadoop или передаваться через conf. Доступ к Metastore и файловой системе использует существующий кеш учетных данных Kerberos.
Каждое подключение каталога сохраняет клиент Metastore для повторного использования. Клиент поддерживает восстановление после определенных сбоев подключения и аутентификации. Чтобы очистить кешированный клиент Metastore и записи каталога, выполните следующий запрос:
SELECT success
FROM hms_clear_cache();
После этого следующая операция сможет установить новое подключение без повторного отключения и подключения каталога.
Поддерживаемые форматы таблиц и ограничения
Расширение поддерживает следующие форматы таблиц через Hive Metastore.
| Формат | Чтение | Запись | Ограничения |
|---|---|---|---|
Parquet |
Поддерживается |
Поддерживается |
Поддерживаются секционированные таблицы. При создании секционированной таблицы столбцы секционирования должны располагаться в конце определения таблицы |
CSV |
Поддерживается |
Поддерживается |
При создании таблицы необходимо указать формат |
Apache Paimon |
Поддерживается |
Поддерживается |
Поддерживается только добавление данных. Вставка данных в таблицы с первичным ключом не поддерживается. Расположение таблиц должно соответствовать структуре хранилища Paimon. Каждая вставка фиксирует новый снепшот |
Apache Iceberg |
Поддерживается |
Поддерживается |
Поддерживается только добавление данных. Поддерживаются версии формата 1 и 2; таблицы версии 3 с отслеживанием происхождения строк отклоняются. Отсортированные таблицы отклоняются, если не включен параметр |
Avro |
Поддерживается |
Не поддерживается |
Только чтение |
При работе с Hive существуют следующие ограничения:
-
Поддержка Iceberg и Avro встроена в расширение ADO. Отдельная установка или загрузка этих расширений не требуется. Не загружайте стандартное расширение Iceberg для DuckDB в том же процессе, поскольку его регистрации конфликтуют со встроенной реализацией.
-
Расширение не поддерживает чтение транзакционных таблиц Hive (ACID). Такие таблицы отклоняются, а их базовые файлы и файлы delta не интерпретируются как полный набор данных.
-
Все таблицы, создаваемые через каталог Hive Metastore, являются внешними таблицами. Расширение не записывает управляемые таблицы Hive ACID.
-
При удалении таблицы DuckDB всегда удаляет запись из Metastore. Файлы данных удаляются только в том случае, если для таблицы задано
external.table.purge=true. -
По умолчанию
external.table.purgeвключен для расположения, выбранного каталогом, и отключен для расположения, указанного явно черезlocation. Поэтому при удалении таблицы с явно заданным расположением файлы данных обычно сохраняются. Если требуется другое поведение, явно задайтеexternal.table.purgeпри создании таблицы.
Apache Paimon
К таблицам Paimon, зарегистрированным в Hive Metastore, можно обращаться с запросами и добавлять в них данные через каталог. Расширение определяет таблицы Paimon по обработчику хранилища, зарегистрированному в Metastore.
Запись поддерживает только добавление данных. Вставка данных в таблицы с первичным ключом не поддерживается, хотя такие таблицы можно читать. Расположение таблиц должно соответствовать структуре хранилища Paimon: <warehouse>/<database>.db/<table>.
Например:
SELECT count(*)
FROM hms.default.orders;

CREATE TABLE hms.default.events (
    id INTEGER,
    dt VARCHAR,
    v BIGINT
)
PARTITIONED BY (dt)
WITH (
    format = 'paimon',
    location = 'hdfs://nameservice1/warehouse/default.db/events'
);

INSERT INTO hms.default.events
SELECT range, '2026-07-15', range * 2
FROM range(1000);
Каждая вставка фиксирует новый снепшот.
Apache Iceberg
К таблицам Iceberg, зарегистрированным в Hive Metastore, можно обращаться с запросами и добавлять в них данные через каталог. Запись поддерживает только добавление данных. Операции DELETE, UPDATE и MERGE не поддерживаются.
Расширение поддерживает версии формата Iceberg 1 и 2. Таблицы версии 3 с отслеживанием происхождения строк отклоняются. Отсортированные таблицы отклоняются, если не включен параметр unsafe_iceberg_ignore_sort_order.
Для получения метаданных Iceberg расширение использует текущее значение metadata_location из Metastore. При фиксации изменений оно обновляет этот указатель с помощью оптимистической проверки в рамках эксклюзивной блокировки таблицы в Hive Metastore. Если другой процесс записи одновременно изменяет указатель метаданных, фиксация изменений может завершиться ошибкой вместо перезаписи изменений другого процесса.
В секционированных таблицах Iceberg поддерживаются секционирование по идентичности и преобразования, включая bucket(N, col), truncate(W, col), year(col), month(col), day(col) и hour(col).
Например:
SELECT count(*)
FROM hms.default.orders;

CREATE TABLE hms.default.events (
    id INTEGER,
    dt VARCHAR,
    v BIGINT
)
PARTITIONED BY (dt)
WITH (
    format = 'iceberg',
    location = 'hdfs://nameservice1/warehouse/events'
);

INSERT INTO hms.default.events
SELECT range, '2026-07-16', range * 2
FROM range(1000);
Примеры использования
Чтение и запись данных в HDFS
В следующем примере данные считываются из файла Parquet в HDFS, агрегируются, а результат записывается обратно в HDFS:
SELECT cat,
       count(*) AS n,
       round(avg(r), 3) AS avg_r,
       max(id) AS max_id
FROM 'hdfs://nameservice1/user/analytics/events.parquet'
GROUP BY cat
ORDER BY cat;
DuckDB считывает столбцы, необходимые для выполнения агрегации. При наличии поддержки также возможно проталкивание проекций и фильтров на уровень сканирования файлов.
Чтобы просмотреть схему Parquet без сканирования всего набора данных, выполните следующий запрос:
SELECT name, type
FROM parquet_schema(
    'hdfs://nameservice1/user/analytics/events.parquet'
);
Чтобы прочитать несколько файлов, используйте шаблон glob:
SELECT count(*)
FROM 'hdfs://nameservice1/data/year=2026/*.parquet';
Также поддерживаются рекурсивные шаблоны glob:
SELECT count(*)
FROM 'hdfs://nameservice1/data/year=2026/**/*.parquet';
Чтобы записать результат агрегации обратно в HDFS, выполните следующий запрос:
COPY (
    SELECT cat,
           count(*) AS n,
           round(avg(r), 3) AS avg_r
    FROM 'hdfs://nameservice1/user/analytics/events.parquet'
    GROUP BY cat
)
TO 'hdfs://nameservice1/user/analytics/summary.parquet'
(FORMAT parquet);
У настроенной учетной записи Hadoop должны быть права на запись в целевое расположение. Те же шаблоны SQL можно использовать с файлами CSV и другими поддерживаемыми средствами чтения файлов DuckDB.
Чтение и запись данных в Ozone
В следующем примере выполняется запрос к файлам Parquet, хранящимся в бакете Ozone:
SELECT cat, count(*) AS n
FROM 'ofs://om.example.com:9862/vol1/warehouse/**/*.parquet'
GROUP BY cat;
Чтобы записать результат запроса в Ozone, выполните следующую команду:
COPY (
    SELECT 42 AS x
)
TO 'ofs://om.example.com:9862/vol1/warehouse/result.parquet'
(FORMAT parquet);
Том и бакет Ozone должны уже существовать, а у настроенной учетной записи должны быть необходимые разрешения.
Если DuckDB не может обработать схему ofs:// или подключиться к Ozone Manager, проверьте файлы конфигурации Ozone и убедитесь, что конфигурация Hadoop задана до выполнения первого запроса к файловой системе.
Подключение каталога Hive Metastore и выполнение запросов
Подключите каталог Metastore и выполните запрос к зарегистрированной таблице:
ATTACH 'thrift://hms.example.com:9083' AS hms (
    TYPE hive_metastore,
    WAREHOUSE_LOCATION 'hdfs://nameservice1/warehouse'
);

SELECT *
FROM hms.default.events
LIMIT 10;
Каталог получает метаданные таблицы через Hive Metastore и считывает базовые файлы с использованием настроенной файловой системы.
Чтобы создать таблицу, вставить данные и выполнить запрос к результату, используйте следующие команды:
CREATE TABLE hms.default.trips (
    id INTEGER,
    fare BIGINT
)
WITH (
    format = 'parquet',
    location = 'hdfs://nameservice1/warehouse/trips'
);

INSERT INTO hms.default.trips
SELECT range, range * 2
FROM range(1000);

SELECT count(*), sum(fare)
FROM hms.default.trips;
Таблица регистрируется в Hive Metastore, а ее данные записываются в указанное расположение. Другие движки, поддерживающие соответствующий формат таблицы и расположение, могут обращаться к данным через каталог.
Чтобы создать секционированную таблицу Parquet, используйте PARTITIONED BY. Столбцы секционирования должны находиться в конце определения таблицы:
CREATE TABLE hms.default.events (
    id INTEGER,
    payload VARCHAR,
    day INTEGER
)
PARTITIONED BY (day)
WITH (
    format = 'parquet',
    location = 'hdfs://nameservice1/warehouse/events'
);

INSERT INTO hms.default.events
SELECT range, 'event_' || range, range % 7
FROM range(1000);
Расширение создает структуру директорий для секционированной таблицы и регистрирует записанные секции в Metastore. Другие движки, включая Spark и Hive, могут обращаться к данным через каталог.
При вставке данных в существующую секционированную таблицу Parquet расширение добавляет данные в соответствующие секции. Значения секционирования хранятся в именах директорий, а не в самих файлах Parquet.