

Использование pg_duckdb
- Обзор
- Установка
- Поддерживаемые типы
- Транзакции в pg_duckdb
- Предустановленные расширения DuckDB
- Примеры
Обзор
ADP/PostgreSQL хорошо справляется с транзакционной нагрузкой (OLTP), но уступает специализированным решениям при обработке тяжелых аналитических запросов (OLAP). Расширение pg_duckdb интегрирует колоночно-векторизованный аналитический движок DuckDB в ADP/PostgreSQL, обеспечивая высокопроизводительную аналитику и работу с ресурсоемкими приложениями. Это позволяет выполнять аналитические SQL-запросы на данных ADP/PostgreSQL с высокой производительностью, не переписывая код и не экспортируя данные в отдельный формат. Расширение доступно в Enterprise-версии ADP.
Расширение pg_duckdb включает набор функций, которые позволяют читать внешние файлы (Parquet, CSV, JSON), работать с озерами данных (Iceberg, Delta), управлять кешем DuckDB и секретами, а также использовать нативные SQL‑функции DuckDB напрямую из ADP/PostgreSQL. В этой статье приведено несколько примеров использования функций pg_duckdb. Для получения полного и актуального списка функций обратитесь к официальной документации: Functions.
Установка
Пакет, требуемый для установки pg_duckdb, поставляется с ADP. Чтобы использовать pg_duckdb, выполните следующие шаги:
-
На вкладке Primary Configuration сервиса ADPG добавьте
pg_duckdbк значению параметраshared_preload_librariesполя postgresql.conf раздела ADPG configurations (см. Настройка сервисов).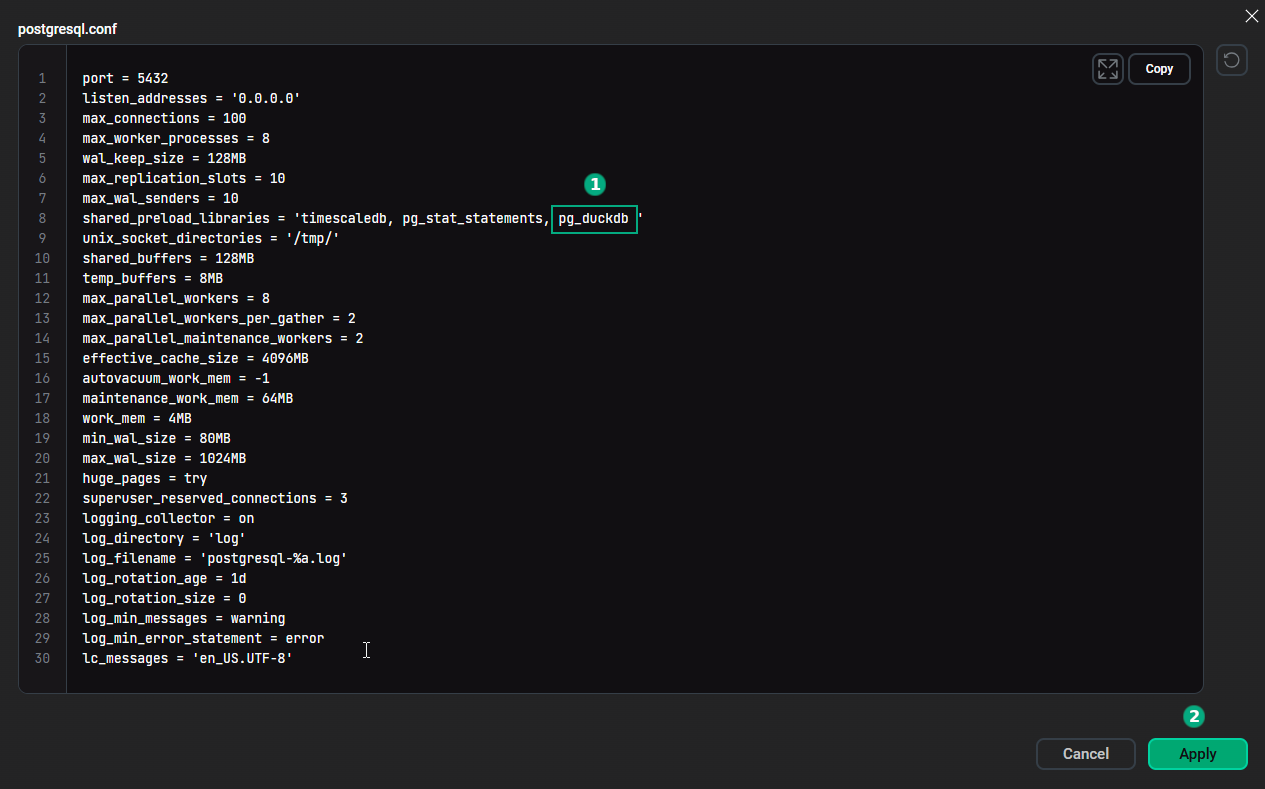 Установка параметра "shared_preload_libraries"
После изменения postgresql.conf нажмите Save и выполните действие Reconfigure & Restart, чтобы применить изменения.
-
Выполните команду CREATE EXTENSION в той базе данных, в которую вы хотите установить расширение (можно использовать psql или любую другую утилиту для подключения к базе данных):
CREATE EXTENSION pg_duckdb;
|
ПРИМЕЧАНИЕ
Если расширение pg_duckdb создано в базе данных template1, используемой в качестве шаблона по умолчанию, во всех вновь создаваемых базах данных будет установлено это расширение.
|
ADP использует версию
1.1.0
расширения pg_duckdb. Чтобы это проверить, можно выполнить следующий запрос:
SELECT extversion FROM pg_extension
    WHERE extname = 'pg_duckdb';
extversion ------------ 1.1.0
После создания расширения pg_duckdb его функции становятся доступны в текущей базе данных. Достаточно установить параметр duckdb.force_execution в значение true для использования SQL-движка DuckDB при выполнении запросов:
SET duckdb.force_execution = true;Поддерживаемые типы
Расширение pg_duckdb поддерживает следующие типы данных для использования в запросах:
-
целочисленные типы (
integer,bigintи другие); -
числа с плавающей точкой (
real,double precision); -
numeric(может быть преобразован вdouble precision, еслиpg_duckdbне поддерживает требуемую точность); -
text,varchar,bpchar; -
типы
bit, включая как массивы битов фиксированного, так и переменного размера; -
bytea,blob; -
timestamp,timestamptz,date,interval,timestamp_ns,timestamp_ms,timestamp_s; -
boolean; -
uuid; -
json, jsonb; -
domain; -
массивы для всех вышеперечисленных типов, с некоторыми ограничениями для многомерных массивов (см. Known limitations).
Специальные типы
Расширение pg_duckdb вводит несколько специальных типов PostgreSQL. Вам не следует использовать эти типы явно, но они могут упоминаться в сообщениях об ошибках ADP/PostgreSQL.
duckdb.row
Тип duckdb.row возвращается функциями read_parquet, read_csv, scan_iceberg и им подобными. Такие функции могут возвращать строки с разными столбцами и типами в зависимости от их аргументов. Укажите имя столбца в квадратных скобках, чтобы получить значение конкретного столбца:
SELECT t['name'], t['description'] FROM read_parquet('parquet_file') t WHERE t['price'] < 100;Если вы используете выражение SELECT *, результат запроса не будет содержать столбец с типом duckdb.row. Все столбцы получат свои реальные типы:
SELECT * FROM read_parquet('parquet_file');duckdb.unresolved_type
Расширение pg_duckdb использует тип duckdb.unresolved_type, чтобы ADP/PostgreSQL мог понять выражение, тип которого неизвестен на этапе разбора запроса. После того как pg_duckdb выполнит запрос, фактический тип будет заполнен движком DuckDB. Таким образом, результат запроса никогда не будет содержать столбец с типом duckdb.unresolved_type.
Вы можете получить ошибки, сообщающие о том, что функция или оператор не существует для duckdb.unresolved_type. Например:
ERROR: function my_function(duckdb.unresolved_type) does not exist
LINE 13: my_function(t['column1']) as column1
В этом случае явно приведите аргумент к типу, который принимает функция: my_function(t['column1']::text) as column1.
Если необходимо вставить результат выражения SELECT в таблицу (команда INSERT INTO), явно приведите к необходимому типу столбец, извлеченный с помощью синтаксиса t['column_name']:
INSERT INTO table1 SELECT t['height']::float FROM read_csv('buildings.csv') t;Выражение, возвращаемое синтаксисом t['column_name'], имеет тип duckdb.unresolved_type. Его фактический тип становится известен только после того, как pg_duckdb выполнит запрос, но ADP/PostgreSQL необходимо знать тип при разборе запроса INSERT — без приведения типа вы получите ошибку.
duckdb.json
Расширение pg_duckdb использует duckdb.json в качестве аргументов JSON-функций pg_duckdb. Тип duckdb.json позволяет этим функциям принимать значения JSON, JSONB и duckdb.unresolved_type.
За более подробной информацией о типах, которые поддерживает pg_duckdb, и об ограничениях их использования обратитесь к статье Types.
Транзакции в pg_duckdb
Расширение pg_duckdb поддерживает транзакции с несколькими операциями, но имеет важное ограничение — не рекомендуется выполнять запись одновременно в таблицу ADP/PostgreSQL и таблицу DuckDB в рамках одной транзакции. Вы можете выполнять DDL-операции (например, CREATE TABLE, DROP TABLE) с таблицами DuckDB внутри транзакции, но не допускается объединять такие операторы с DDL-операциями, затрагивающими объекты ADP/PostgreSQL.
Чтобы отключить это ограничение и разрешить запись как в DuckDB, так и в ADP/PostgreSQL в рамках одной транзакции, установите для параметра duckdb.unsafe_allow_mixed_transactions значение true. Это может стать причиной того, что транзакция будет зафиксирована только в DuckDB, но не в ADP/PostgreSQL, что приведет к несогласованности и потере данных. Например, следующий код может привести к удалению таблицы duckdb_table без копирования ее содержимого в pg_table:
BEGIN;
SET LOCAL duckdb.unsafe_allow_mixed_transactions TO true;
CREATE TABLE pg_table AS SELECT * FROM duckdb_table;
DROP TABLE duckdb_table;
COMMIT;
Предустановленные расширения DuckDB
pg_duckdb поддерживает большое количество расширений DuckDB, которые дополняют функциональность pg_duckdb для различных сценариев использования.
По умолчанию предустановлены и загружены следующие расширения:
-
httpfs— реализует поддержку файловой системы HTTP/S3, позволяя читать и записывать файлы в удаленных хранилищах; -
json— позволяет использовать функции и операторы для работы с JSON.
Примеры
Раздел содержит несколько примеров, иллюстрирующих часто используемые сценарии работы с pg_duckdb.
Использование pg_duckdb для запросов к таблицам ADP/PostgreSQL
Создайте таблицу и заполните ее данными:
CREATE TABLE books (
    id SERIAL PRIMARY KEY,
    title VARCHAR(255) NOT NULL,
    genre VARCHAR(50),
    price NUMERIC(10, 2),
    total_sales BIGINT);

INSERT INTO books (title, genre, price, total_sales)
VALUES
    ('Mrs. Dalloway', 'novel', 360, 6212880),
    ('To the Lighthouse', 'novel', 440, 7216000),
    ('To Kill a Mockingbird', 'novel', 750, 11574000),
    ('The Great Gatsby', 'novel', 900, 11110500),
    ('The Lord of the Rings', 'fantasy', 1200, 5472000),
    ('1984', 'sci-fi', 520, 9642880),
    ('The Hobbit, or There and Back Again', 'fantasy', 1100, 19679000),
    ('War and Peace', 'novel', 1500, 32548500),
    ('Hyperion', 'sci-fi', 610, 8411290),
    ('The Time Machine', 'sci-fi', 450, 6444450);

SET duckdb.force_execution = true;
Выполните команду EXPLAIN ANALYZE, чтобы отобразить план выполнения запроса:
EXPLAIN ANALYZE SELECT genre, AVG(price) AS average_price, COUNT(*) AS books_count
    FROM books GROUP BY genre ORDER BY average_price DESC;
В выводе видно, что запрос выполнен движком DuckDB:
                                                QUERY PLAN
-----------------------------------------------------------------------------------------------------------------
 Custom Scan (DuckDBScan) (cost=0.00..0.00 rows=0 width=0) (actual time=0.001..0.002 rows=0 loops=1)
   DuckDB Execution Plan:

 ┌─────────────────────────────────────┐
 │┌───────────────────────────────────┐│
 ││    Query Profiling Information    ││
 │└───────────────────────────────────┘│
 └─────────────────────────────────────┘
 EXPLAIN ANALYZE SELECT genre, avg(price) AS average_price, count(*) AS books_count FROM pgduckdb.public.books
    GROUP BY genre ORDER BY (avg(price)) DESC
 ┌────────────────────────────────────────────────┐
 │┌──────────────────────────────────────────────┐│
 ││              Total Time: 0.0093s             ││
 │└──────────────────────────────────────────────┘│
 └────────────────────────────────────────────────┘
 ┌───────────────────────────┐
 │           QUERY           │
 └─────────────┬─────────────┘
 ┌─────────────┴─────────────┐
 │      EXPLAIN_ANALYZE      │
 │    ────────────────────   │
 │           0 rows          │
 │          (0.00s)          │
 └─────────────┬─────────────┘
 ┌─────────────┴─────────────┐
 │          ORDER_BY         │
 │    ────────────────────   │
 │   avg(books.price) DESC   │
 │                           │
 │           3 rows          │
 │          (0.00s)          │
 └─────────────┬─────────────┘
 ┌─────────────┴─────────────┐
 │       HASH_GROUP_BY       │
 │    ────────────────────   │
 │         Groups: #0        │
 │                           │
 │        Aggregates:        │
 │          avg(#1)          │
 │        count_star()       │
 │                           │
 │           3 rows          │
 │          (0.00s)          │
 └─────────────┬─────────────┘
 ┌─────────────┴─────────────┐
 │         PROJECTION        │
 │    ────────────────────   │
 │           genre           │
 │           price           │
 │                           │
 │          10 rows          │
 │          (0.00s)          │
 └─────────────┬─────────────┘
 ┌─────────────┴─────────────┐
 │         TABLE_SCAN        │
 │    ────────────────────   │
 │        Table: books       │
 │                           │
 │        Projections:       │
 │           genre           │
 │           price           │
 │                           │
 │          10 rows          │
 │          (0.01s)          │
 └───────────────────────────┘

 Planning Time: 0.521 ms
 Execution Time: 0.421 ms
Выполните запрос и просмотрите результат, чтобы убедиться в корректной работе движка DuckDB:
SELECT genre, AVG(price) AS average_price, COUNT(*) AS books_count
FROM books GROUP BY genre ORDER BY average_price DESC;
genre | average_price | books_count ---------+-------------------+------------- fantasy | 1150 | 2 novel | 790 | 5 sci-fi | 526.6666666666666 | 3
Чтение данных из csv-файла
Расширение pg_duckdb содержит функцию read_csv, позволяющую получать данные из CSV-файлов.
Например, следующий файл CSV находится по пути tmp/books.csv:
id,title,author_id,public_year,genre
1,Mrs. Dalloway,1,1925,novel
2,To the Lighthouse,1,1927,novel
3,To Kill a Mockingbird,2,1960,novel
4,The Lord of the Rings,4,1955,fantasy
5,1984,5,1949,sci-fi
Выполните запрос ниже, чтобы вывести значения полей title и public_year:
SELECT t['title'], t['public_year']
     FROM read_csv('file:///tmp/books.csv') t;
title | public_year -----------------------+------------- Mrs. Dalloway | 1925 To the Lighthouse | 1927 To Kill a Mockingbird | 1960 The Lord of the Rings | 1955 1984 | 1949
Можно в одном запросе объединять данные из CSV-файлов и из таблиц базы данных. Создайте таблицу authors для демонстрации этой функциональности:
CREATE TABLE authors (
    id SERIAL PRIMARY KEY,
    author_name VARCHAR(100) NOT NULL,
    country VARCHAR(20)
);

INSERT INTO authors (author_name, country) VALUES
    ('Virginia Woolf', 'Great Britain'),
    ('Harper Lee', 'USA'),
    ('F. Scott Fitzgerald', 'USA'),
    ('J.R.R. Tolkien', 'Great Britain'),
    ('George Orwell', 'Great Britain');
Следующий запрос выводит список книг из файла books.csv и имена их авторов из таблицы authors:
SELECT t1['title'], t1['public_year'], t2.author_name FROM read_csv('file:///tmp/books.csv') t1
    INNER JOIN authors t2
    ON t1['author_id'] = t2.id;
title | public_year | author_name -----------------------+-------------+---------------- To the Lighthouse | 1927 | Virginia Woolf To Kill a Mockingbird | 1960 | Harper Lee The Lord of the Rings | 1955 | J.R.R. Tolkien 1984 | 1949 | George Orwell Mrs. Dalloway | 1925 | Virginia Woolf
Функция read_csv также позволяет получать данные CSV-файлов из S3-хранилищ. Для этого необходимо создать секрет, как показано в примере Чтение файлов из S3-хранилища.
Чтение данных из JSON-файла
Функция read_json позволяет получать данные из JSON-файлов.
Например, имеется JSON-файл по пути tmp/orders.json:
[{"customer": "Jacob Johnson",
  "book": "Hyperion",
  "qty": 3
},
{"customer": "Adam Brown",
  "book": "War and Peace",
  "qty": 2
},

{"customer": "Andrew Nelson",
  "book": "1984",
  "qty": 4
}]
Вызовите функцию read_json, передав в качестве параметра путь к файлу:
SELECT * FROM read_json('file:///tmp/orders.json');customer | book | qty ---------------+---------------+----- Jacob Johnson | Hyperion | 3 Adam Brown | War and Peace | 2 Andrew Nelson | 1984 | 4
Функция read_json также позволяет получать данные JSON-файлов из S3-хранилищ. Для этого необходимо создать секрет, как показано в примере Чтение файлов из S3-хранилища.
Операции с файлами Parquet
Расширение pg_duckdb позволяет выполнять запросы над файлами типа Parquet, а также экспортировать данные в этот формат.
Экспорт данных из таблицы ADP/PostgreSQL в формат Parquet
pg_duckdb может экспортировать данные таблиц ADP/PostgreSQL в файлы типа Parquet, находящиеся в разных хранилищах, в том числе облаках, озерах данных и локальном диске компьютера. Код ниже создает файл Parquet с книгами жанра novel на локальном диске по следующему пути: tmp/output_file.parquet:
COPY (SELECT * FROM books WHERE genre = 'novel')
    TO 'file:///tmp/output_file.parquet'
    (FORMAT 'parquet');
Выполнение запросов над файлами типа Parquet
Код ниже использует функцию read_parquet, чтобы отобразить содержимое файла output_file.parquet, созданного в предыдущем примере (t — псевдоним для извлекаемой таблицы):
SELECT t['title'], t['price']
     FROM read_parquet('file:///tmp/output_file.parquet') t;
title | price -----------------------+--------- Mrs. Dalloway | 360.00 To the Lighthouse | 440.00 To Kill a Mockingbird | 750.00 The Great Gatsby | 900.00 War and Peace | 1500.00
Объединение данных ADP/PostgreSQL и Parquet в одном запросе
Вы можете обращаться к таблицам ADP/PostgreSQL и внешним источникам данных в рамках одного запроса. Следующий код выводит строки из таблицы books, которых нет в файле Parquet:
SELECT t1.* FROM books t1
    LEFT JOIN read_parquet('file:///tmp/output_file.parquet') t2 ON t1.id = t2['id']
    WHERE t2['id'] IS NULL;
id | title | genre | price | total_sales ----+-------------------------------------+---------+---------+------------- 5 | The Lord of the Rings | fantasy | 1200.00 | 5472000 6 | 1984 | sci-fi | 520.00 | 9642880 7 | The Hobbit, or There and Back Again | fantasy | 1100.00 | 19679000 9 | Hyperion | sci-fi | 610.00 | 8411290 10 | The Time Machine | sci-fi | 450.00 | 6444450
Чтение файлов из S3-хранилища
В DuckDB хранение учетных данных (таких как ключи доступа, токены, пароли и прочее) реализовано через секреты. Секреты позволяют базе данных подключаться к защищенным внешним хранилищам или удаленным серверам без указания ключей в каждом запросе.
Чтобы подключиться к S3-хранилищу, сначала создайте секрет, используя функцию duckdb.create_simple_secret:
SELECT duckdb.create_simple_secret(
      type      := 'S3',
      key_id    := 'Access_key',
      secret    := 'Secret_key',
      region    := 'ru-central1',
      endpoint  := 'storage.yandexcloud.net',
      use_ssl   := 'false'
);
S3-хранилище содержит файл test.parquet, в котором есть столбцы PassengerId и Name. Выполните следующий запрос, чтобы вывести данные из этого файла:
SELECT t['PassengerId'] AS id, t['Name'] AS name
    FROM read_parquet('s3://test-bucket/test/test.parquet') t;
где test-bucket — название бакета, test/test.parquet — путь к файлу в бакете.
 id  |       name
-----+---------------------
 1   | Jacques Heath
 2   | Timothy McCarthy
 3   | Laina Heikkinen
 4   | Jacques Futrelle
 5   | William Allen
 6   | James Moran
 7   | Elisabeth Walton
 8   | Kornelia Theodosia
 9   | Oscar Johnson
 10  | Madeleine Talmage
Преобразование CSV-файла в файл формата Parquet
pg_duckdb позволяет конвертировать CSV-файлы в формат Parquet, не создавая PostgreSQL-таблиц. Сконвертируйте файл books.csv, приведенный выше, в Parquet-файл, используя следующий запрос:
COPY (SELECT t['id']::integer,
             t['title']::text,
             t['author_id']::integer,
             t['public_year']::integer,
             t['genre']::text FROM read_csv('file:///tmp/books.csv') t)
    TO 'file:///tmp/books.parquet' (FORMAT 'parquet');
Обратите внимание, что для успешной конвертации необходимо явно указать типы столбцов. В противном случае парсер ADP/PostgreSQL не сможет разобрать данные для передачи в команду COPY, так как функция read_csv возвращает тип duckdb.row.
Создание высокопроизводительных временных таблиц
Расширение pg_duckdb позволяет создавать высокопроизводительные временные таблицы с помощью конструкции USING duckdb. При таком подходе выполнение операций и хранение данных временной таблицы осуществляются в колоночном движке DuckDB, работающем в оперативной памяти, что позволяет полностью обойти более медленные механизмы PostgreSQL — строковое хранилище (heap) и журнал предзаписи (WAL).
Конструкция USING duckdb для постоянных таблиц заблокирована на локальном уровне и требует интеграции с MotherDuck. Однако для временных таблиц ограничений нет: они создаются напрямую внутри движка DuckDB.
Создайте временную таблицу, используя данные из таблицы books:
CREATE TEMP TABLE temp_books USING duckdb AS
    SELECT id, title, genre, price, total_sales
    FROM books;
Выполните команду \dt+:
\dt+List of relations Schema | Name | Type | Owner | Persistence | Access method | Size | Description -----------+------------+-------+----------+-------------+---------------+------------+------------- pg_temp_6 | temp_books | table | postgres | temporary | duckdb | 0 bytes | public | books | table | postgres | permanent | heap | 8192 bytes |
Вы можете увидеть в выводе, что методом доступа к таблице temp_books является duckdb.
Любые операции агрегирования, группировки и сканирования для временной таблицы, созданной с использованием USING duckdb, будут выполняться движком DuckDB со скоростью, характерной для OLAP-баз данных.